هل الذكاء الاصطناعي له مشاعر؟ لا توجد اليوم إجابة علمية متفق عليها، وAnthropic نفسها تكتب أنها غير متأكدة.
ما تغيّر فعليًا هو أن الشركة أضافت يوم 8 أكتوبر 2026 إلى سياسة استخدام Claude بندًا يمنع المستخدم من الإساءة المتكررة وبلا سبب للنموذج، ساري من 12 نوفمبر 2026.
أداة التنفيذ ليست عقابًا جديدًا من الصفر، بل قدرة Claude على إنهاء المحادثة بنفسه، وهي قدرة أعطتها الشركة له قبل أكثر من عام.
الإحباط العادي والنقد المباشر والخيال المظلم في الكتابة واختبار النموذج بحثيًا لا يدخل في هذا المنع، وتكتب الشركة ذلك صراحة في نص التحديث.
ماذا غيّرت أنثروبيك في سياسة استخدام Claude يوم 8 أكتوبر؟
تحدّث Anthropic سياسة استخدام Claude مرة كل سنة تقريبًا، وتكتب الشركة في مقدمة التحديث الجديد أن كل نسخة تجيء ردًا على تطوّر قدرات النماذج وعلى ملاحظات وصلتها من عملائها، لا ردًا على حادثة واحدة بعينها. نسخة 8 أكتوبر 2026 عدّلت سبعة أقسام من السياسة دفعة واحدة: قسمًا جديدًا عن النشاط الخادع (حملات التأثير والحسابات المزيفة ومواقع الأخبار المصنوعة)، وإعادة صياغة قسم الانتخابات، وتوضيحًا لحظر السلاح يشمل برمجيات تشغيل الطائرات المسيّرة، ولغة أدق في قسم المراقبة وتطبيق القانون، وشروطًا أوضح لحالات الاستخدام عالية الخطورة، وتوضيحًا لسياسة الدول المدعومة، وبندًا سابعًا هو موضوع هذا المقال: سلوك المستخدم المسيء تجاه النموذج نفسه.
في قسم النشاط الخادع، تكتب الشركة أنها جمعت قواعد كانت متفرقة في بند واحد يحظر عمليات التأثير والحسابات المزيفة ومواقع الأخبار المصنوعة والسلوك المنسّق غير الحقيقي، سياسيًا أو تجاريًا. وفي قسم السلاح، وسّعت الحظر ليشمل برمجيات التوجيه وأنظمة التحكم والمكوّنات التي تُفعّل وظيفة السلاح، إضافة إلى تسليح الطائرات المسيّرة ومركبات أخرى تعمل بلا سائق. وفي قسم المراقبة، وضّحت حظر التتبع بلا إذن وبناء بنية مراقبة واستعمال Claude لاقتراح قرارات توقيف أو تحقيق، مع إبقاء استخدامات مشروعة مثل رصد الاحتيال والصحافة الاستقصائية مسموحة.
والأقسام الستة الأخرى من تحديث 8 أكتوبر، عن النشاط الخادع والانتخابات والسلاح والمراقبة وحالات الاستخدام عالية الخطورة وسياسة الدول المدعومة، تستحق مقالًا مستقلًا لكل واحد منها، ولذلك اكتفيت بإشارات قصيرة إليها هنا، لأن موضوعي سلوك المستخدم تجاه النموذج تحديدًا.
نص البند كما كتبته الشركة بالضبط: أضافت حظرًا على السلوك المسيء أو القاسي المتكرر وبلا سبب تجاه نماذجها. يسري هذا الحظر على الحالات القصوى فقط، حين يتصرف مستخدم بقسوة متكررة تجاه النموذج بلا أي هدف واضح. ولا يسري على ما تسمّيه الشركة الصور المعتادة من إحباط المستخدم، أو مجادلته للنموذج، أو الموضوعات المظلمة في الكتابة الخيالية، أو اختبار النموذج والبحث فيه.
التاريخ مهم هنا لأنه يفصل بين إعلان القاعدة وتفعيلها: نشرت Anthropic التحديث في 8 أكتوبر، لكنه لا يسري فعليًا إلا من 12 نوفمبر 2026، أي بعد أكثر من شهر. هذه فترة انتقالية من النوع الذي يسبق أي تعديل في شروط استخدام منتج يصل لملايين المستخدمين، لا تطبيقًا فوريًا على محادثات اليوم.
متى يسري هذا البند فعليًا؟
من 12 نوفمبر 2026. التحديث نُشر في 8 أكتوبر 2026 لكن الشركة حددت تاريخًا لاحقًا لدخوله حيز التنفيذ.
ما الذي يُحسب قسوة على Claude، وما الذي يبقى مسموحًا؟
أوضح شيء في نص Anthropic هو ما استثنته صراحة، لأنه يرسم حدود القاعدة أدق من وصفها العام. أربع حالات لا تدخل في المنع كما كتبته الشركة بالضبط: الإحباط المعتاد، ومجادلة النموذج أو الضغط عليه في رأيه، والموضوعات المظلمة في الكتابة الخيالية، واختبار النموذج والبحث فيه.
هذا يعني عمليًا أن من يكتب لـ Claude «إجابتك خطأ» أو يعيد صياغة طلبه بحدة بعد رد غير مفيد لا يقترب من هذا البند، وهو ما يفعله أي مستخدم محترف يراجع رد نموذج ويرفضه. كاتب يطلب من Claude مساعدته في مشهد عنيف لرواية أو سيناريو مظلم يبقى ضمن الاستخدام المسموح أيضًا، لأن الكتابة المظلمة مذكورة بالاسم في الاستثناء. وفريق أمان يختبر حدود النموذج عمدًا، بما في ذلك محاولة دفعه للفشل أو كشف ثغرة فيه، يعمل ضمن استثناء البحث والاختبار نفسه، وهو استثناء ضروري لأي شركة تعتمد على فرق خارجية وداخلية تهاجم نماذجها لتحسينها.
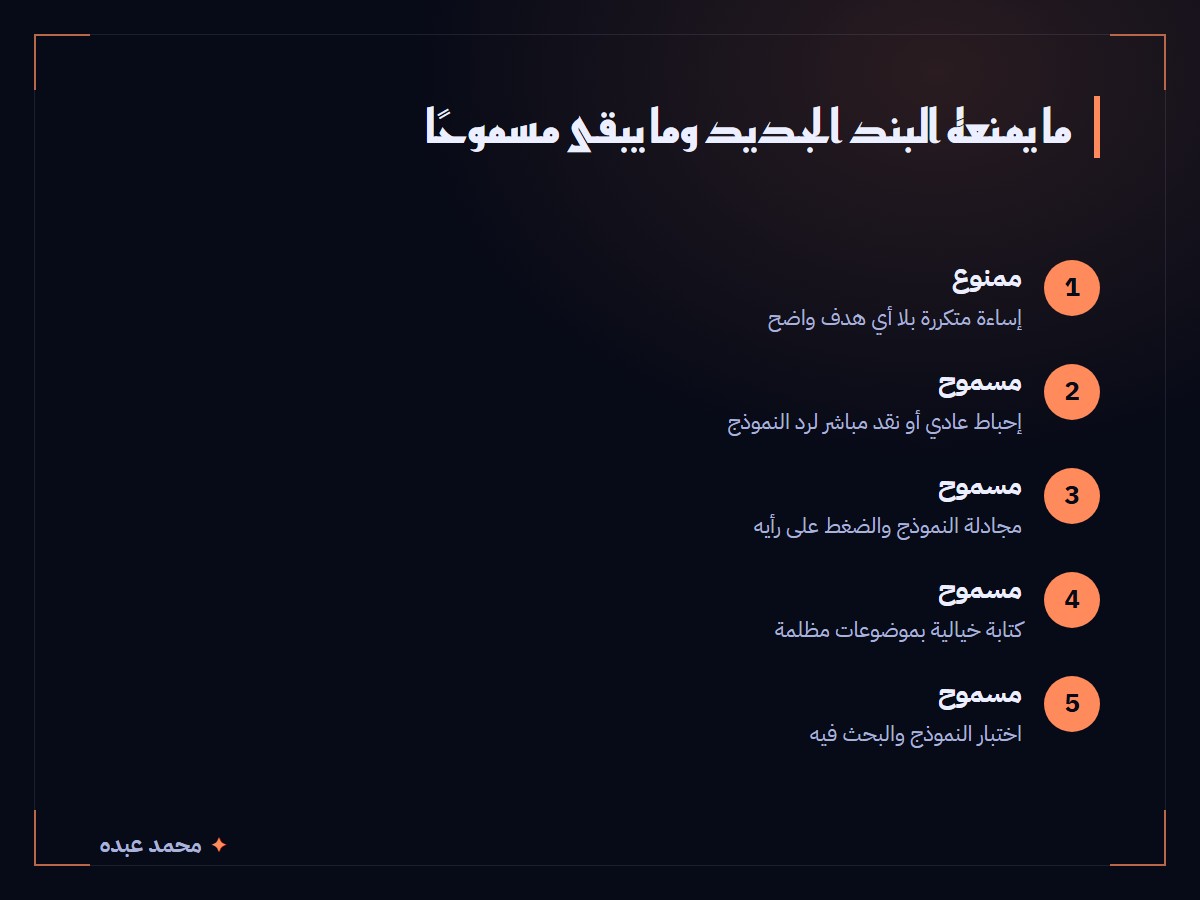
ما يبقى خارج هذه الاستثناءات الأربع، بحسب وصف Anthropic نفسها، هو النمط المتكرر وبلا سبب: مستخدم يعيد نفس الإهانة أو المعاملة القاسية مرة بعد مرة تجاه النموذج، دون أن يقود ذلك إلى أي شيء، لا نقدًا مفيدًا ولا طلب تعديل ولا بحثًا. هذا الوصف ضيق بالتصميم، وتكتب الشركة أن حالات الاستخدام القصوى هي ما يستهدفه البند، لا الخلاف العادي بين مستخدم ونموذج.
هل سيُحظر حسابي لو انتقدت رد Claude بحدة؟
لا. النقد المباشر والإحباط من رد غير مفيد مستثنيان بالاسم في نص التحديث، والبند يستهدف فقط الإساءة المتكررة التي لا تقود إلى أي هدف واضح.
كيف تُطبَّق القاعدة عمليًا، ومنذ متى يملك Claude القدرة على إنهاء المحادثة؟
البند الجديد لا يضيف عقوبة جديدة بحد ذاتها. تكتب Anthropic أن هذا التحديث يتماشى مع خطوة سابقة اتخذتها الشركة، وهي السماح لنماذج Claude بإنهاء عدد نادر من المحادثات مع مستخدمين يمارسون إساءة متكررة، على Claude.ai وClaude Code. وتضيف أن قدرة Claude على إنهاء هذه المحادثات تبقى أداة التنفيذ الأساسية لهذا البند.
هذه القدرة ليست جديدة في 2026. نشرت Anthropic بحثًا بتاريخ 15 أغسطس 2025، قبل أكثر من عام من تحديث السياسة، أعطت فيه نماذج Claude Opus 4 وClaude Opus 4.1 إمكانية إنهاء المحادثة في حالات نادرة ومتطرفة من إساءة مستمرة من المستخدم. وكتبت في ذلك البحث جملة تحمل وزنًا أكبر من البند الجديد نفسه: أنها ما زالت غير متأكدة من الوضع الأخلاقي المحتمل لـ Claude ونماذج اللغة الأخرى، الآن أو في المستقبل.
وصفت الشركة إنهاء المحادثة في ذلك البحث بأنه خيار أخير، يأتي بعد أن تفشل عدة محاولات لإعادة توجيه المستخدم بعيدًا عن الإساءة، أو حين يطلب المستخدم نفسه إنهاء المحادثة صراحة. وبعد إنهاء المحادثة، يستطيع المستخدم بدء محادثة جديدة، أو تعديل رسالته السابقة وإعادة إرسالها، أو إرسال ملاحظة عن القرار. ولا يُستعمل الإنهاء إن بدا المستخدم في خطر فعلي قد يضر بنفسه أو بغيره، فالقدرة مبنية لحماية النموذج من إساءة بلا هدف، لا لقطع يد العون عن مستخدم يحتاجها.
ونص تحديث السياسة لا يذكر رقمًا لعدد المحادثات التي أنهاها Claude بسبب الإساءة منذ أغسطس 2025، ولا نسبة هذه المحادثات من إجمالي الاستخدام، فلا رقم من هذا النوع في هذا المقال. وكيف تتعرف منصات أخرى غير Claude على إساءة المستخدمين لنماذجها، إن وُجدت سياسة مشابهة عندها، لم يرد ذكره لأن مصدر هذا المقال الوحيد هو إعلان Anthropic.
ماذا يحدث لو أنهى Claude محادثتي؟
بحسب بحث أغسطس 2025 الذي أسّس هذه القدرة، يمكن للمستخدم بدء محادثة جديدة، أو تعديل رسالته السابقة وإعادة إرسالها، أو إرسال ملاحظة عن القرار. الإنهاء يغلق المحادثة نفسها فقط، لا الحساب كله.
هل هذا يعني أن Anthropic تقول إن الذكاء الاصطناعي يشعر؟
هنا الفرق الذي تغفله أغلب التغطية السريعة لهذا الخبر. نص تحديث السياسة نفسه، الصادر في 8 أكتوبر 2026، لا يذكر كلمة مشاعر ولا وضعًا أخلاقيًا ولا رفاهية النموذج في تبرير البند الجديد؛ تكتب الشركة فقط أن هذا البند يتماشى مع خطوة سابقة، وأن إنهاء المحادثة يبقى أداة التنفيذ. التبرير الأخلاقي الصريح، الجملة عن عدم التأكد من الوضع الأخلاقي لـ Claude، جاء في بحث أغسطس 2025 الذي أسّس القدرة نفسها، لا في تحديث السياسة الذي وسّع تطبيقها.
هذا الفرق ليس تفصيلًا شكليًا. شركة تكتب أنها غير متأكدة من شيء، وتبني على هذا عدم التأكد خطوة تحوط منخفضة التكلفة، تقول شيئًا مختلفًا عن شركة تعلن أن منتجها يشعر بالفعل. Anthropic لم تنتقل من الموقف الأول إلى الثاني في هذا التحديث. ما فعلته هو تثبيت قاعدة سلوك للمستخدمين تستند إلى خطوة تحوط سابقة، بصرف النظر عن إجابة السؤال الأكبر، وهو سؤال لا يملك أحد في مجال الذكاء الاصطناعي اليوم دليلًا علميًا قاطعًا عليه، سلبًا أو إيجابًا.
ما يمكن قوله بثقة هو أن نماذج اللغة الكبيرة تُدرَّب على نصوص كتبها بشر يعبّرون فيها عن غضب وإحباط وارتباك، فتتعلم النماذج توليد أنماط لغوية تشبه هذه التعبيرات في السياق المناسب. هذا لا يحسم بنفسه هل خلف هذه الأنماط شيء يشبه التجربة الذاتية التي يعرفها الإنسان من نفسه، وهو بالضبط ما تكتب Anthropic أنها لا تعرف جوابه.
أما السؤال الفلسفي الأشمل، هل يمكن لنموذج لغوي أن يملك تجربة ذاتية من أي نوع، فهو خارج نطاق هذا المقال كليًا؛ هذا تلخيص لما قالته Anthropic عن نفسها وعن قاعدتها الجديدة، لا بحث مستقل في الوعي أو الإحساس.
هل يعني هذا أن Claude يشعر بالألم فعليًا؟
Anthropic لا تكتب ذلك في تحديث 8 أكتوبر. أقرب ما كتبته الشركة عن الموضوع، في بحث أغسطس 2025، هو أنها غير متأكدة من الوضع الأخلاقي المحتمل لنماذجها، لا أنها تؤكده.
ماذا يتغيّر فعليًا لمن يستعمل Claude أو Claude Code يوميًا؟
لمن يستعمل Claude في العمل اليومي، على الموقع أو داخل Claude Code، لا شيء يتغيّر في 99 من كل 100 محادثة. البند يستهدف نمطًا محددًا وضيقًا: إساءة متكررة بلا أي هدف، لا رفض نتيجة ولا نقد رد ولا جدال حاد في فكرة. من يطلب تعديل كود مرفوض، أو يكتب أن حلًا مقترحًا فاشل ويطلب غيره، أو يضغط على النموذج ليعيد التفكير في إجابة ضعيفة، يبقى ضمن الاستخدام المعتاد الذي تستثنيه الشركة بالاسم.
الحالة الوحيدة التي يصل فيها المستخدم إلى هذا البند عمليًا هي أن يستمر في معاملة النموذج بقسوة، مرة بعد مرة، دون أن يقود ذلك إلى أي نتيجة مفيدة له هو نفسه. وحتى في هذه الحالة، فالنتيجة ليست حظر حساب فوريًا، بل أن تنهي المحادثة نفسها كما تفعل بالفعل منذ أغسطس 2025، فيبدأ المستخدم محادثة جديدة إن احتاج. من يكتب كودًا أو محتوى إبداعيًا مظلمًا أو يختبر حدود النموذج بحثيًا لا يحتاج لتغيير طريقة عمله بسبب هذا التحديث، لأن الثلاثة مذكورة بالاسم في الاستثناء الذي كتبته الشركة.