لتشغيل نموذج ذكاء اصطناعي محلي تحتاج ذاكرة تساوي حجم ملف النموذج، زائد ما بين 0.6 و1 جيجا
تقريبًا للسياق، زائد 3 إلى 4 جيجا يتركها جهازك لنظام التشغيل. وحجم الملف تحسبه بنفسك: اضرب عدد
معاملات النموذج بالمليار في 0.61 فتحصل على حجمه بالجيجا بدقة Q4_K_M، وهي الدقة التي أنصح بها
لأغلب الناس. على جهاز بذاكرة 8 جيجا يدخل نموذج بحجم 4 مليار معامل، وعلى 16 جيجا يدخل 14 مليارًا،
وعلى 32 جيجا يدخل 32 مليارًا. جرّبتُ المعادلة على أربعة نماذج رسمية يوم 28 أكتوبر 2026 فأخطأت
بأقل من اثنين بالمئة.
كيف تحسب حجم النموذج قبل أن تحمّله؟
النموذج في النهاية ملف أرقام. كل رقم منها يسمى معاملًا، وعدد المعاملات هو الرقم الذي تراه في اسم
النموذج: 8B تعني ثمانية مليارات. وكل معامل يُخزَّن بعدد من البتات، وهنا تختلف الدقة. بدقة 16 بت
(النموذج الكامل) يأخذ المعامل بايتين، فنموذج الثمانية مليارات يحتاج نحو 16 جيجا. أما النسخ
المضغوطة التي يحملها الناس لأجهزتهم فتخزّن المعامل في 4 إلى 8 بتات تقريبًا، ولهذا يصغر الملف
إلى الثلث أو النصف.
بدل أن أصدّق قاعدة تقول «4 بت تعني نصف بايت»، قسمتُ الملفات الحقيقية. حملتُ قائمة الملفات من
مستودعات Qwen3 الرسمية على Hugging Face، وقسمتُ حجم كل ملف بالبايت على عدد معاملات نموذجه، فخرجت
هذه المعدلات الفعلية لكل معامل:
| الدقة | البتات الفعلية لكل معامل (أصغر قيمة إلى أكبر قيمة في أربعة نماذج) |
|---|---|
| Q4_K_M | من 4.83 إلى 4.97 |
| Q6_K | من 6.56 إلى 6.58 |
| Q8_0 | من 8.50 إلى 8.51 |
اسم «Q4» يوحي بأربع بتات، لكن الواقع قريب من خمس، لأن بعض الطبقات تُحفظ بدقة أعلى. هذا أول خطأ
وقعتُ فيه: بدأتُ بالمعادلة «المعاملات × 0.5 بايت»، فخرج لي ملف الثمانية مليارات 4.1 جيجا بينما
الملف الحقيقي 5.03. الفرق نحو جيجا كاملة، وهي تكفي لتجعل جهازًا بذاكرة 6 جيجا يفشل في التحميل
بعد أن ظننتَ أن النموذج يدخل. بعد أن اعتمدتُ المعدل المقيس 4.9 بت (أي المعاملات × 0.61) صارت
النتائج كالتالي:
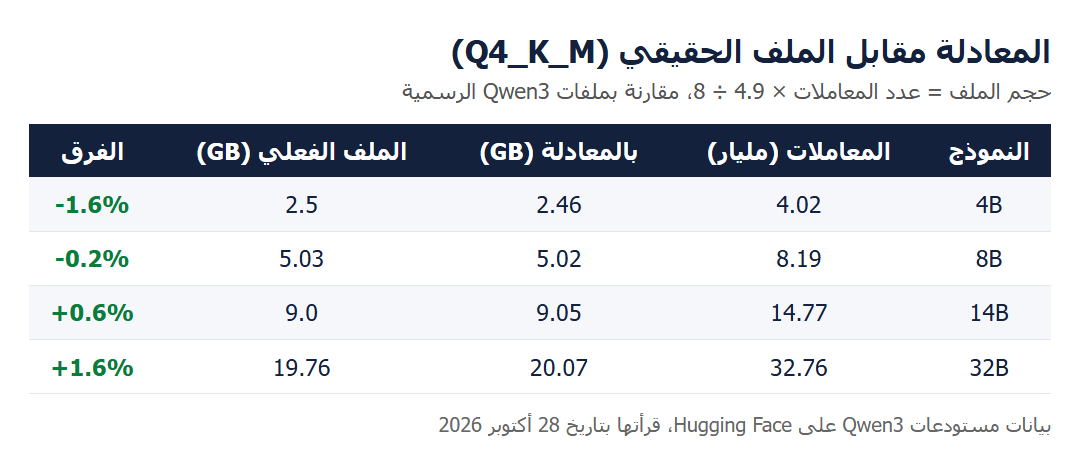
أكبر انحراف كان 1.6 بالمئة، مرة بالزيادة ومرة بالنقص. هذا يكفي لقرار تحميل، فلا تحتاج حاسبة
أونلاين. تنبيه صغير: هذه الأرقام لعائلة Qwen3 بصيغة GGUF. نماذج أخرى أو صيغ أخرى قد تعطي معدلًا
قريبًا لا مطابقًا، فاقرأ حجم الملف في صفحة التحميل قبل أن تقرر.
ما الرقم الذي تضربه فيه لكل دقة؟
بما أن البتات الفعلية معروفة لكل دقة، حوّلتُها إلى رقم واحد تضربه في عدد المعاملات بالمليار
فتحصل على الجيجابايت. خرج من الملفات نفسها هذا الجدول، وأضفتُ إليه دقة Q5_K_M التي قسّمتُها
كذلك فجاءت بين 5.67 و5.75 بت:
| الدقة | اضرب المعاملات بالمليار في |
|---|---|
| fp16 (النموذج الكامل) | 2.00 |
| Q8_0 | 1.06 |
| Q6_K | 0.82 |
| Q5_K_M | 0.71 |
| Q4_K_M | 0.61 |
الدقة الأقل تعني ملفًا أصغر وجودة أقل قليلًا. لا أستطيع أن أعطيك نسبة للخسارة في الجودة لأنني لم
أقسها، لكن الاتجاه معروف: النزول من Q8_0 إلى Q6_K خسارته صغيرة، وكل نزول بعد Q4_K_M يظهر في
جودة الإجابات أكثر. لذلك أبدأ دائمًا من Q4_K_M، وأصعد إلى دقة أعلى فقط إن بقيت ذاكرة فارغة بعد
الحساب.
ما الذي يأكل الذاكرة غير الملف نفسه؟
الملف هو الجزء الثابت. بعد التحميل يحتاج النموذج ذاكرة لشيء ثانٍ يسمى KV cache، وهو ما يحفظه
النموذج من المحادثة ليتذكر ما قلتَه قبل ثلاث رسائل. كلما طالت المحادثة كبر هذا الجزء.
حسبتُه من ملف config.json في كل مستودع رسمي. لكل توكن يحفظ النموذج مفتاحًا وقيمة في كل طبقة،
فالمعادلة هي: عدد الطبقات × عدد رؤوس KV × 128 × 2 (مفتاح وقيمة) × 2 بايت (دقة fp16). نموذج 8B
فيه 36 طبقة و8 رؤوس، فيخرج 147456 بايتًا لكل توكن:
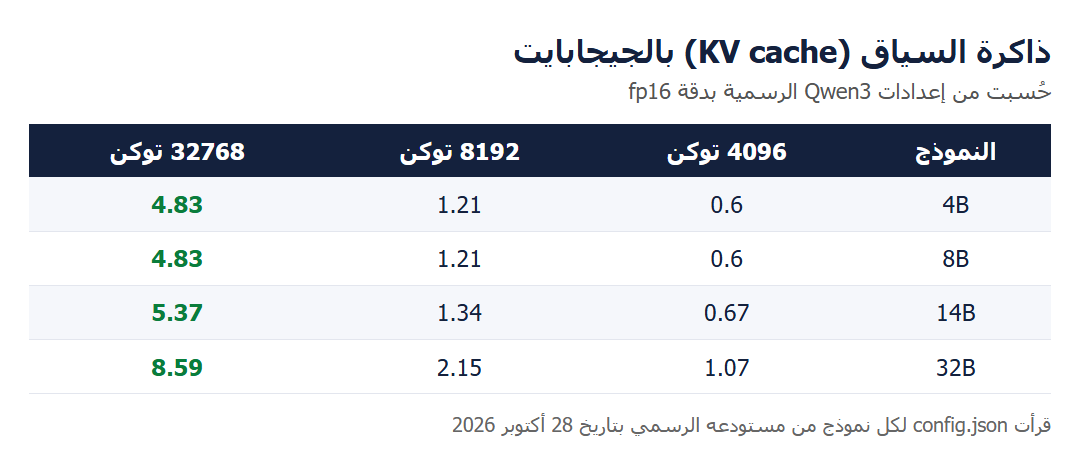
عند 4096 توكن، وهي محادثة متوسطة الطول، لا يتجاوز الجزء 1.07 جيجا حتى في أكبر نموذج جرّبته.
لكن عند 32768 توكن يقفز إلى 4.83 جيجا في النموذج الصغير و8.59 في الأكبر، أي أكثر من نصف حجم
الملف نفسه أحيانًا. إن كنت ستلصق مستندات طويلة في المحادثة فاحسب هذا الجزء مع حسابك، لا بعده.
قرأتُ يوم 28 أكتوبر 2026 صفحة سياق النماذج في توثيق Ollama، وفيها أن الأداة تختار طول السياق
تلقائيًا بحسب الذاكرة: 4 آلاف توكن إن كانت الذاكرة أقل من 24 جيجا، و32 ألفًا بين 24 و48 جيجا،
و256 ألفًا لما فوق 48. معنى ذلك أن جهازًا عاديًا يشتغل افتراضيًا بالمحادثة القصيرة، وأن رفع
السياق من الإعدادات يستهلك ذاكرة إضافية كما في الجدول أعلاه.
مثال: نموذج 8B على ذاكرة 16 جيجا والمستند طويل
لنفترض أنك تريد أن تلصق تقريرًا طويلًا في نموذج 8B بدقة Q4_K_M، وأن السياق المطلوب 32768 توكن.
الملف 5.03 جيجا، والسياق 4.83، فالمجموع 9.86. على جهاز بذاكرة 16 جيجا يتبقى لك نحو 2 إلى 3 جيجا
بعد النظام، وهذا يعمل. على جهاز بذاكرة 8 جيجا لا يعمل مهما فعلت، رغم أن النموذج نفسه كان
«يدخل» عند 4096 توكن. هذا هو الخطأ الذي يقع فيه من يحسب الملف وحده: يحمّل النموذج بنجاح، ثم
تتجمد الأداة أو تنهار عند أول مستند طويل، فيظن أن البرنامج معطوب والمشكلة في الحساب.
أي نموذج يدخل في ذاكرة 8 و16 و32 جيجا؟
جمعتُ الملف وذاكرة السياق عند 4096 توكن، وطرحتُ من ذاكرة الجهاز ما بين 3 و4 جيجا للنظام
والمتصفح. هذا الطرح تقدير مني من التجربة وليس رقمًا رسميًا، فجهازك قد يترك أكثر أو أقل.
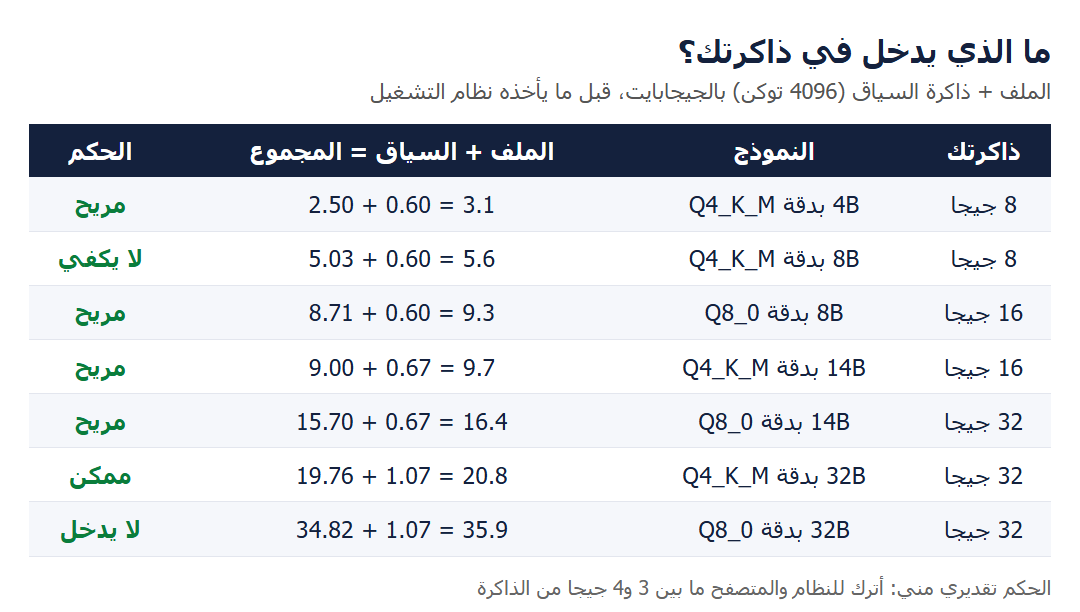
الخلاصة من الجدول أن ذاكرة 8 جيجا تناسب نموذجًا بأربعة مليارات معامل، وأن الثمانية مليارات
تقف على الحد فتأخذ 5.6 جيجا من 4 إلى 5 المتاحة لك. وفي 16 جيجا تختار بين نموذج أصغر بدقة
أعلى (8B بدقة Q8_0) أو نموذج أكبر بدقة أقل (14B بدقة Q4_K_M)، والكبير بدقة أقل هو خياري غالبًا،
لأن النموذج الأكبر يفهم أكثر حتى بعد الضغط. وفي 32 جيجا يدخل 32B بدقة Q4_K_M بهامش ضيق، بينما
النسخة Q8_0 منه تحتاج 35.9 جيجا فلا تدخل.
هل هذا الاختيار صحيح من ناحية الجودة؟ لم أقِس الجودة هنا، فتجربتي كانت على الذاكرة فقط. ما قلتُه
عن تفضيل الأكبر المضغوط على الأصغر الدقيق قاعدة شائعة بين من يشغّلون هذه النماذج، وليست نتيجة
اختبار أجريتُه في هذا المقال.
ثلاثة أسئلة تختصر الحساب كله
لو أردت أن تحمل الطريقة في رأسك، فهي ثلاث خطوات: اطرح ما يحتاجه جهازك، ثم احسب حجم النموذج
بالمعادلة، ثم أضف السياق.
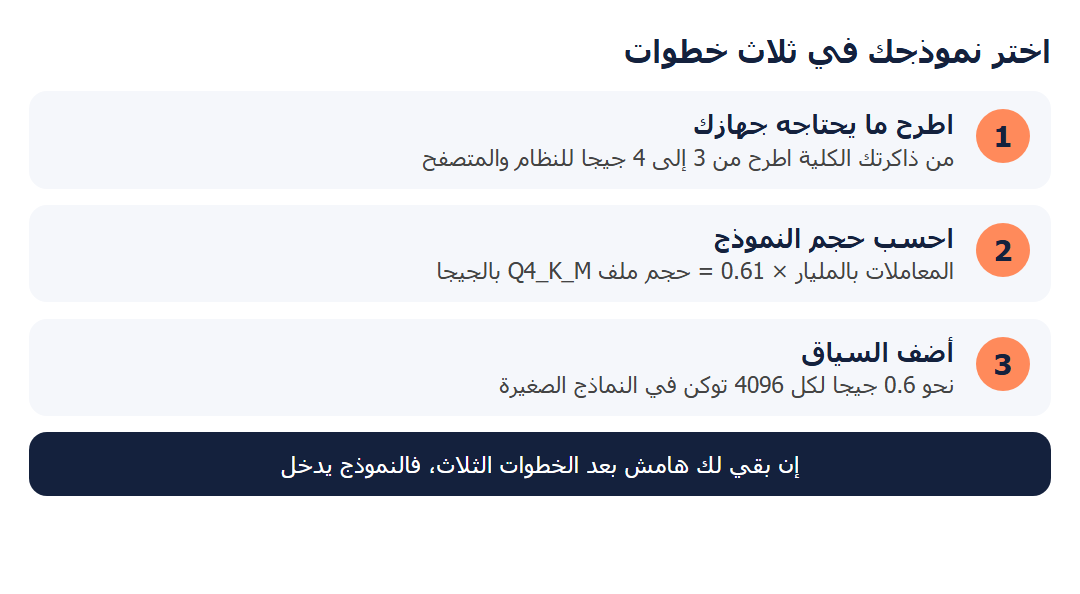
مثال كامل: جهازك 16 جيجا وتريد نموذجًا بأربعة عشر مليارًا. تطرح 4 فيبقى 12. تحسب 14.77 × 0.61
فيخرج 9.0 جيجا، وهو بالفعل حجم ملف Q4_K_M لهذا النموذج. تضيف 0.67 جيجا للسياق فيصير المجموع
9.7، وتبقى لك 2.3 جيجا هامشًا. النموذج يدخل. والآن جرّب الخطوات نفسها على نموذج 32B في الجهاز
نفسه: 32.76 × 0.61 تعطي 20 جيجا، وهو أكبر من الـ 12 المتاحة، فلا داعي لمحاولة التحميل أصلًا.
هل الرام وحدها تكفي أم تلزم بطاقة شاشة؟
الذاكرة العامة (الرام) وذاكرة بطاقة الشاشة (VRAM) شيئان مختلفان، والأداة تحاول وضع النموذج في
الثانية أولًا لأنها أسرع. إن لم يتسع، قسّمته بين البطاقة والرام. ينجح هذا، لكن السرعة تنزل بوضوح
لأن جزءًا من الحساب يمر عبر المعالج. توثيق Ollama نفسه ينصح بتجنّب هذا التقسيم لأفضل أداء،
ويقول إن الأمر ollama ps يريك النسبة بين المعالج والبطاقة تحت عمود PROCESSOR.
الحساب الذي عملناه هنا يخص الذاكرة التي يُحمَّل فيها النموذج، أيًّا كانت. أما السرعة، أي كم
كلمة يكتب في الثانية، فلم أقِسها، لأنها تعتمد على جهازك وبطاقتك أكثر من أي معادلة. إن أخبرك أحد
برقم محدد للسرعة بلا ذكر جهازه فتجاهله.
هل يعمل نموذج 8 جيجا على لابتوب بذاكرة 8 جيجا؟
يعمل، لكن بحسب الجدول لن يكون مريحًا. 5.6 جيجا للنموذج والسياق تترك لك نحو 2.4 جيجا فقط من
8، وهذا لا يكفي لمتصفح بعدة تبويبات. إن كان جهازك بهذه الذاكرة فالنموذج الأصغر (بحجم أربعة
مليارات) أنسب، وأغلق باقي البرامج قبل التجربة.
هل ذاكرة الهاتف تكفي لنموذج محلي؟
الحساب نفسه ينطبق: اطرح ما يستعمله النظام، واحسب الملف والسياق. لكن هواتف كثيرة تعطي كل تطبيق
حصة أقل من الذاكرة الكلية، وهذه الحصة لم أقِسها، فابدأ بنموذج أصغر مما يقوله الحساب.
ماذا عن النماذج التي تحمل عبارة MoE في اسمها؟
بعض النماذج تذكر في اسمها رقمين، مثل المعاملات الكلية والمعاملات النشطة. المعادلة هنا تستعمل
الرقم الكلي، لأن كل الخبراء داخل الملف يجب أن تكون محمّلة في الذاكرة حتى لو شغّلتَ بعضها فقط
في كل خطوة. الرقم النشط يخص السرعة لا الذاكرة. لم أجرّب هذا النوع في هذا المقال، فتحقق من حجم
الملف المنشور قبل الاعتماد على الحساب.
كيف أعرف ذاكرة جهازي الفعلية؟
على ويندوز افتح مدير المهام ثم تبويب الأداء ثم الذاكرة، والرقم الأعلى هو الإجمالي. وراقب ما
يُستعمل وأنت فاتح المتصفح وبرامجك المعتادة، فهو أصدق من أي رقم تقديري. هذا الرقم المستعمَل هو
ما يجب أن تطرحه في الخطوة الأولى، لا الرقم 4 الذي افترضتُه لجهاز عادي. حين قست جهازي هذا الصباح
كانت ذاكرته 23.7 جيجا، وأي نموذج يزيد مجموعه عن 18 جيجا تقريبًا كان سيضغطه.
متى لا يكون النموذج المحلي هو الحل؟
ثلاث حالات رأيتُها تتكرر. الأولى أن تريد جودة أعلى مما يدخل في جهازك، والنماذج الكبيرة المستضافة
أقوى بكثير من أي نسخة تقدر على تحميلها في 8 جيجا. والثانية أنك تحتاج الكتابة بالعربية بجودة
عالية، وحجم النموذج الصغير يظهر في العربية أكثر من الإنجليزية، وهذا انطباع من تجاربي وليس قياسًا
خرجتُ به هنا. والثالثة أن عملك قصير ومتقطع: ساعة كل أسبوع لا تبرر إعداد الجهاز وتحميل ملفات
بحجم عدة جيجابايتات.
أما حين يكون هدفك خصوصية بياناتك، أو العمل بلا اتصال، أو تجربة نماذج مفتوحة، فالمحلي منطقي حتى
لو كان أضعف. وللحالات الأخرى أنصح بالبدء من دليلك الأول مع Claude، ثم
تعلّم كتابة الطلبات بدقة عبر مهارة prompt-master، لأن النماذج الصغيرة
المحلية تتأثر بوضوح الطلب أكثر من الكبيرة، فالطلب المرتب يعوّض جزءًا من الفرق.
إن أردت أن تطبّق هذا على عملك، فيمكنك حجز جلسة ساعة كاملة معي، تُخصم من أي مشروع ننفّذه معًا.