سيرة ذاتية ATS بالذكاء الاصطناعي تعني أن تعطي الأداة سيرتك وإعلان الوظيفة، فتعيد صياغة السيرة في عمود واحد بعناوين قياسية (الخبرة العملية، التعليم، المهارات) وبكلمات الإعلان نفسها، بلا جداول ولا صور ولا أشرطة مهارات.
الذكاء الاصطناعي يكتب الصياغة جيدًا، لكنه لا يضمن أن الملف الذي ستحمّله سيُقرأ سليمًا؛ هذا يتعلق بنوع الملف وطريقة تصديره.
في تجربتي على سيرة افتراضية بالعربية، ضاعت كلمات من ملف PDF بسبب ترميز الحروف نفسه، لا بسبب التصميم، وخرجت كلها سليمة من ملف DOCX.
فإن كنت تُرسل سيرتك عبر نموذج تقديم على موقع شركة، فالأسلم أن ترفع DOCX إن سمح النموذج، وأن تفحص نص ملفك بنفسك قبل الإرسال.
ما الذي فعلته بالضبط في هذه التجربة؟
جميع البيانات هنا افتراضية: «سارة أحمد» اسم مختلق، والشركة والجامعة مختلقتان، ولا أحد حقيقي وراءهما.
لم أستطع تجربة نظام ATS تجاري حقيقي، فهذه الأنظمة لا تُعطى لمن يريد الفحص، ولا تنشر شركاتها وثائق تشرح كيف تقرأ الملف حرفًا حرفًا. ما فعلته أقرب وأبسط: بنيتُ السيرة نفسها بتصميمين، وصدّرتُ كل واحد منهما إلى PDF، ثم استخرجتُ النص بمكتبتين مستقلتين (pypdf وPyMuPDF)، وبنيتُ نسخة DOCX واستخرجتُ نصها بمكتبة python-docx. بعدها وضعتُ ست كلمات من «إعلان وظيفة مثال» وعددتُ كم منها يُوجد حرفيًا في النص المستخرج.
المطابقة الحرفية هي أبسط ما يفعله أي نظام فرز، وإن فشلت عندها فالنظام الأذكى سيجد صعوبة مثلك. لكن تذكّر أن هذا اختبار استخراج نص، لا اختبار نظام توظيف.
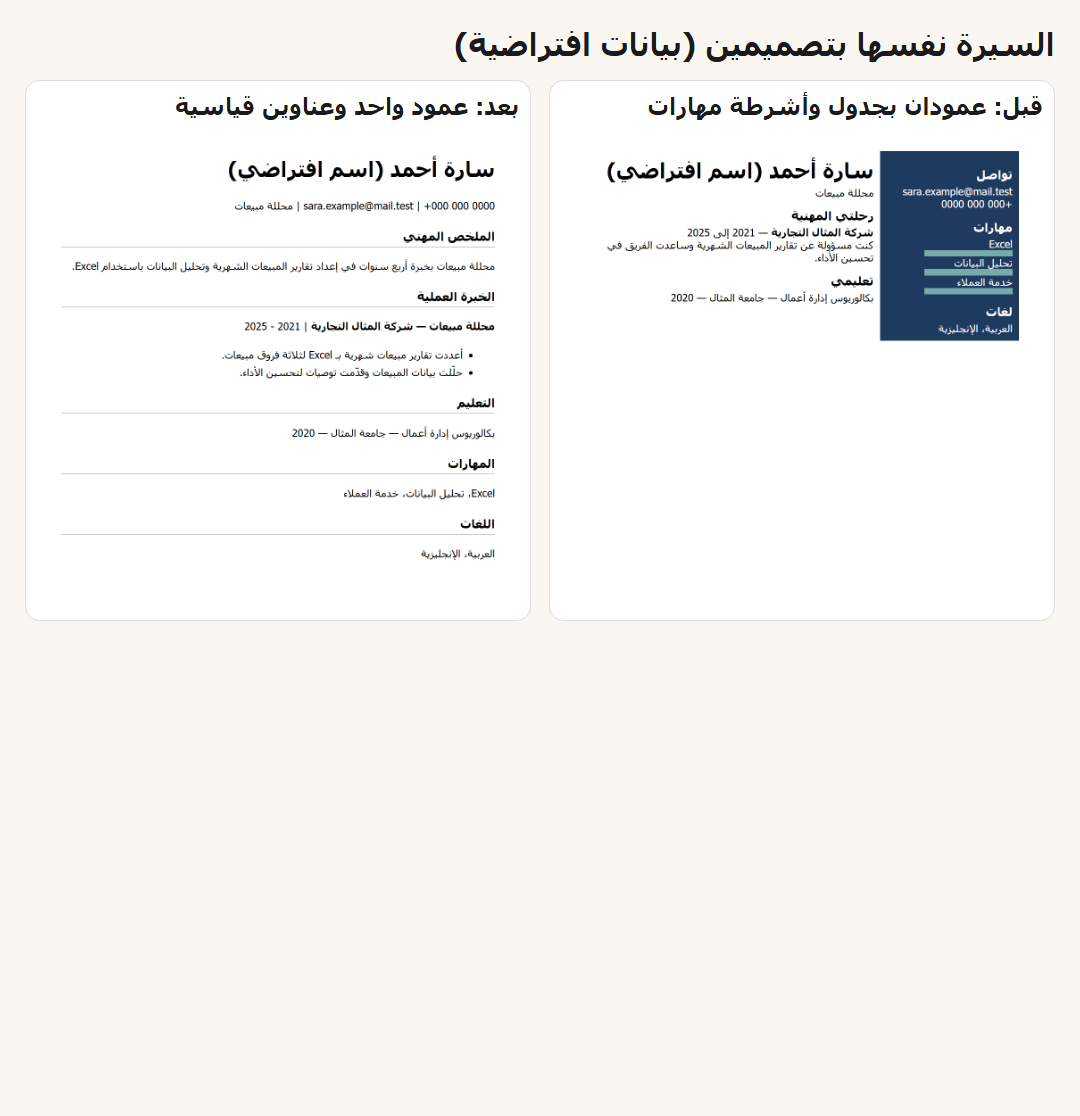
التصميم الأول فيه عمودان داخل جدول، وعمود جانبي ملوّن فيه أشرطة للمهارات وعنوان «رحلتي المهنية» بدل «الخبرة العملية». التصميم الثاني عمود واحد بعناوين عادية. المحتوى في الاثنين واحد، وقد أعدتُ كتابة الثاني بنفسي بالطريقة التي أوصي بها أي أداة ذكاء اصطناعي، وستجد البرومبت كاملًا بعد قليل.
ماذا يضيع من السيرة حين يُقرأ ملف PDF العربي؟
النتيجة الأولى فاجأتني: التصميم لم يكن أكبر مشكلة. الأكبر كان الحروف العربية نفسها.
عند استخراج النص من الـ PDF بمكتبة pypdf، خرجت الحروف بأشكالها البصرية المنفصلة (الحرف في أول الكلمة وفي وسطها وفي آخرها لها رموز مختلفة)، والياء خرجت ياءً فارسية («ی») بدل العربية («ي»). فكلمة «تحليل البيانات» التي أراها على الشاشة لا تطابق نصًا حرفيًا كلمة «تحليل البيانات» التي كتبها صاحب الإعلان. من ست كلمات وُجدت كلمة واحدة فقط، هي Excel لأنها لاتينية.
حين طبّقتُ تطبيعًا بسيطًا (تحويل الأشكال البصرية إلى حروفها الأصلية بدالة NFKC في Python، ثم استبدال الياء الفارسية بالعربية)، ارتفع العدد إلى ست من ست. لكن النظام الذي يقرأ سيرتك قد لا يطبّع شيئًا.
أما مع مكتبة PyMuPDF فكانت الحروف أنظف، لكن ظهرت مشكلة ثانية: كلمات تحوي «لا» تنقلب، فصارت «العملاء» إلى «العمالء»، و«الإنجليزية» إلى «اإلنجليزية». هذا لا يصلحه التطبيع، لأن ترتيب الحرفين انقلب في النص المستخرج نفسه. وجدتُ بالطريقة هذه أربع كلمات من ست، وفقدتُ «خدمة العملاء» التي كانت مطلوبة في الإعلان.
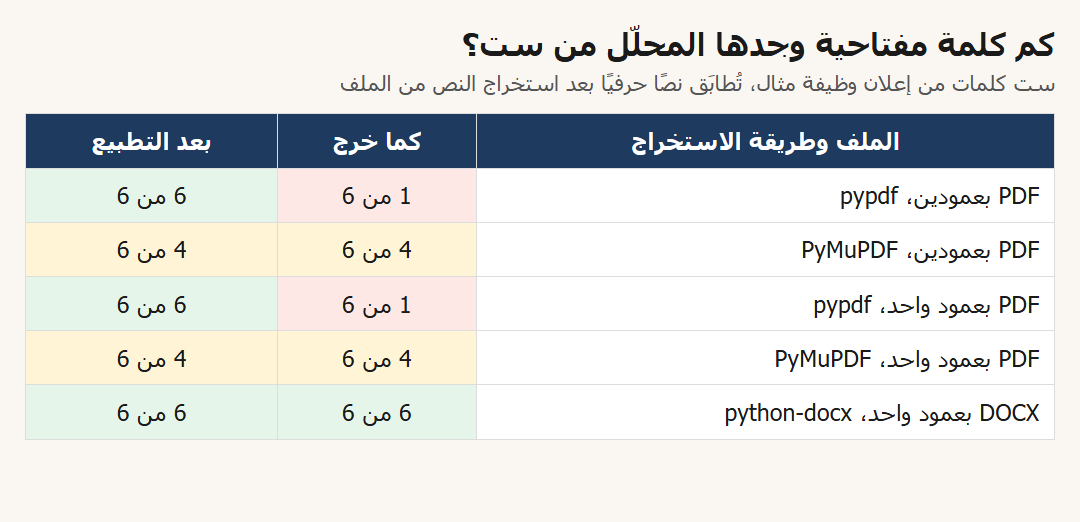
لاحظ أن الجدول لا يفرّق بين التصميمين: العمودان ضاعا بنفس القدر الذي ضاع فيه العمود الواحد. هذا يعني أن مشكلة الـ PDF العربي خاصة بالعربية، وأن نصائح «بلا أعمدة» وحدها لا تحمي سيرتك.
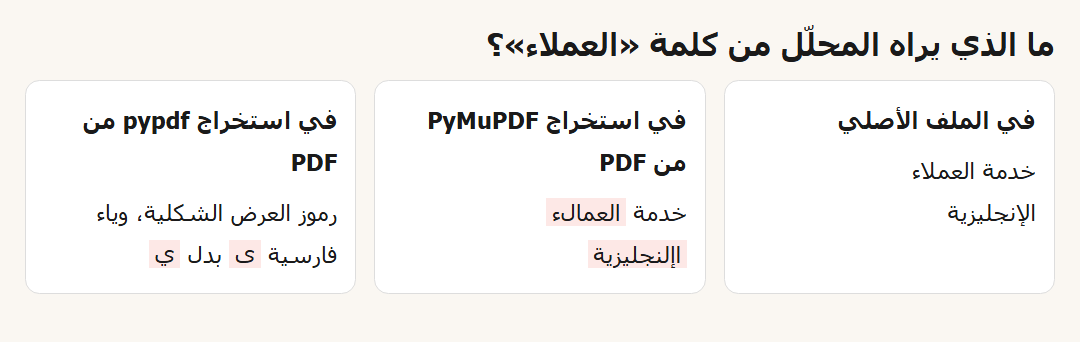
وتحقّقتُ من هذه النتيجة بطريقة ثانية: الملف نفسه، بمكتبتين مستقلتين، أعطى العيبين اللذين وصفتهما. ولم أعدّل في الملف شيئًا بين الاستخراجين.
هل يغيّر التصميم بعمودين شيئًا إذن؟
نعم، لكن في الترتيب لا في الضياع. في استخراج PyMuPDF للتصميم الأول (بجدول) خرج العمود الجانبي كله أولًا: بريدك ورقم هاتفك ثم المهارات واللغات، وبعدها فقط اسمك ومسماك الوظيفي ثم الخبرة. أي أن من يقرأ النص المستخرج يرى المهارات قبل أن يعرف من أنت.
وأمور أخرى ظهرت في التصميم الأول:
- رقم الهاتف خرج مقلوبًا، وعلامة + في آخره بدل أوله.
- في سطر الخبرة صار «2021 إلى 2025» بترتيب مختلف: «2025 إلى 2021».
- عنوان القسم «رحلتي المهنية» لا يعرفه أي محلّل كعنوان قسم الخبرة، فربما لن يربط ما تحته بالخبرة أصلًا.
أما التصميم ذو العمود الواحد فخرج بترتيب صحيح: الاسم، فالملخص، فالخبرة، فالتعليم، فالمهارات. لم أجد فيه إلا مشكلة الحروف المشتركة بين الملفين. وهذا ما يجعلني أنصح بالعمود الواحد حتى لو لم يكن فارقه كبيرًا في اختبار الكلمات.
لا أقول إن كل محلّل سيتعثر بالأعمدة. أقول فقط إن ما جرّبتُه أظهر اختلاف الترتيب، وإن العمود الواحد لا يكلّفك شيئًا.
لماذا نجح DOCX حيث تعثّر PDF؟
ملف DOCX يخزّن النص كما كتبته: حروف عربية أصلية بترتيبها المنطقي. لا أشكال بصرية ولا تحويل. فلما استخرجتُ نص ملف DOCX بمكتبة python-docx وجدتُ الكلمات الست كلها حرفيًا، بلا تطبيع.
ما بنيتُه كان بسيطًا: عنوان للاسم من النوع Heading 1، وعناوين الأقسام من النوع Heading 2، وقائمة نقطية حقيقية من أنماط Word، وكل فقرة بخاصية الاتجاه من اليمين لليسار. لم أستعمل مربع نص ولا جدولًا ولا رأس صفحة.
لكن لا تفهم من هذا أن PDF ممنوع دائمًا: ملف PDF الذي يُصدَّر من محرر نصوص (لا من أداة تصميم أو لقطة شاشة) يحمل طبقة نص، وأنظمة كثيرة تقرؤها. القاعدة العملية التي أخرجتُ بها: إن وُجد خيار DOCX في نموذج التقديم فاستعمله، وإن طلبوا PDF فصدّره من نص حقيقي وافحصه كما سأريك في الخطوة التالية.
كيف أطلب من الذكاء الاصطناعي إعادة كتابة السيرة؟
هذا البرومبت الذي أستعمله (وأعدتُ كتابة السيرة الافتراضية بتعليماته). يصلح لـ Claude وغيره:
أنت تساعدني في إعادة صياغة سيرتي الذاتية لتُقرأ جيدًا في أنظمة الفرز الآلي.

المدخلات:
1) سيرتي الحالية (النص الكامل).
2) إعلان الوظيفة (النص الكامل).

المطلوب:
- أخرج النص فقط بعمود واحد، بلا جداول ولا أشرطة ولا رموز زخرفية.
- استعمل هذه العناوين بهذه الأسماء بالضبط: الملخص المهني، الخبرة العملية، التعليم، المهارات، اللغات.
- في كل وظيفة: المسمى الوظيفي، ثم اسم الجهة، ثم الفترة (سنة - سنة)، ثم نقاط تبدأ بفعل ماضٍ.
- استعمل عبارات الإعلان بنصها حيث تنطبق على خبرتي فعلًا (مثل «تحليل البيانات» لا «قراءة الأرقام»).
- لا تضف مهارة أو رقمًا أو إنجازًا غير موجود في سيرتي. إن كان الإعلان يطلب شيئًا لا أملكه فاذكره لي في آخر ردك ولا تضعه في السيرة.
- اكتب العبارات الإنجليزية (Excel وغيرها) بشكلها الشائع كما في الإعلان.
سطر «لا تضف مهارة أو رقمًا» هو أهم ما في البرومبت. أدوات الذكاء الاصطناعي تميل إلى «تحسين» السيرة بإضافة ما يطلبه الإعلان، فإن لم تمنعها صرتَ تُرسل سيرة فيها مهارات لا تملكها. ثم يسألك المحاور عنها في المقابلة الأولى.
وفي السيرة الافتراضية، حوّلتُ جملة «كنت مسؤولة عن تقارير المبيعات الشهرية وساعدت الفريق في تحسين الأداء» إلى «أعددتُ تقارير مبيعات شهرية بـ Excel لثلاثة فروق مبيعات»، فاتضح لي أنني أضفتُ رقمًا (ثلاثة فروق) لم يكن في الأصل، وهذا بالضبط الخطأ الذي أحذّرك منه. الرقم في المثال خيالي كالسيرة كلها، لكنك في سيرتك الحقيقية لا يجوز أن تقبل من الأداة رقمًا لم تعطها إياه.
كيف تتأكد أن سيرتك تُقرأ قبل أن تُرسلها؟
لا تحتاج أداة. أربع خطوات:
1. افتح ملف PDF النهائي، وحدّد كل النص (Ctrl+A) وانسخه.
2. الصقه في ملف نصي بسيط (المفكرة مثلًا).
3. اقرأ ما خرج: هل الاسم أول سطر؟ هل الأرقام والتواريخ بترتيبها؟ هل كلمة «العملاء» لم تتحول إلى «العمالء»؟
4. ابحث عن ثلاث كلمات من الإعلان بالبحث في الملف النصي. إن لم تجدها وأنت ترى أنها في السيرة، فالمشكلة في الملف لا في الصياغة.
هذا الفحص ليس مثاليًا؛ نسخ نصك من قارئ PDF لا يطابق ما يفعله نظام التوظيف بالضبط. لكنه يكشف الأخطاء التي رأيتُها هنا، والتي تحدث حين يكون ملفك ممسوحًا ضوئيًا أو مصدّرًا من أداة تصميم، فلا يخرج أي نص عند النسخ. وإن لم يخرج عندك شيء، فلن يخرج عندهم.
وإن كنت تصدّر سيرتك من Python أو من أداة تصميم عربية، فمهارة إخراج PDF عربي سليم تعالج مشكلة الاتجاه والحروف في الـ PDF نفسه، وإن كان عملك أوسع من سيرة واحدة فـمهارة مخرجات العروض والمستندات العربية تغطي الـ DOCX والعروض.
ماذا عن الأسئلة التي يكتبها الناس؟
هل أستطيع أن أصنع السيرة بالعربية وأبقى ATS؟
نعم، إن اتبعتَ الشكل أعلاه. لكن كثيرًا من الشركات تقرأ بالإنجليزية فقط أو تفضّلها؛ اسأل إن أمكن، أو جهّز نسختين، واحدة لكل لغة، بنفس العناوين الموافقة لكل لغة.
هل أستعمل Canva أو قالبًا جاهزًا؟
القوالب المصممة غالبًا فيها أعمدة وأيقونات ومربعات نص، وتُصدَّر أحيانًا كصورة داخل PDF. لا أحكم على أداة بعينها، فلم أجرّب Canva في هذه التجربة. لكن اختبار النسخ واللصق أعلاه يخبرك في ثوانٍ إن كان ملفك صالحًا.
هل يكفي أن أضع كل كلمات الإعلان في السيرة؟
لا. ضعها حيث تصدق على خبرتك، وفي سياق جملة (في الخبرة) لا قائمة طويلة منفردة. وأي كلمة لا تنطبق عليك لا تضعها، فالمحاور البشري هو المرحلة التالية دائمًا.
أين أضع بريدي ورقم هاتفي؟
جرّبتُ حالة حدّية أخيرة لأن كثيرًا من قوالب Word تضع بيانات التواصل في رأس الصفحة (Header) لتظهر أنيقة فوق السيرة. بنيتُ ملف DOCX صغيرًا فيه الاسم والمسمى الوظيفي في المتن، والبريد والهاتف في رأس الصفحة، ثم استخرجتُ فقرات المتن بمكتبة python-docx.
الناتج: الاسم والمسمى ظهرا، أما البريد ورقم الهاتف فلم يظهرا إطلاقًا في فقرات المتن. هما موجودان في الملف فعلًا، لكن في جزء مستقل يسميه Word رأس الصفحة، ولا يصل إليه إلا من طلبه صراحة. المكتبة التي استعملتُها تفصل بين الجزأين، ولا أعرف يقينًا هل يطلب نظام التوظيف عندك الجزء الثاني أم لا، وهذا بالضبط سبب أن الرهان عليه خسارة محتملة بلا مقابل.
القاعدة التي خرجتُ بها: ضع الاسم والبريد والهاتف والمدينة في أول المتن، في سطرين على الأكثر، وأبقِ رأس الصفحة وتذييلها فارغين. لن تخسر شيئًا من الشكل، والاحتمال الوحيد الذي تحميه هو ألا تصل جهة التوظيف إلى طريقة التواصل معك أصلًا.
وهناك تفصيل آخر لاحظتُه في ترتيب بيانات التواصل: في ملف PDF خرج رقم الهاتف في استخراج PyMuPDF بصيغة «0000 000 000+» أي بعلامة الجمع في آخره، لأن الرقم لاتيني داخل نص يُقرأ من اليمين. إن أمكنك، اكتب الرقم بصيغة دولية متصلة أو بفواصل بسيطة، واجعله في سطر مستقل عن النص العربي، فيقل تداخل الاتجاهين.
كم مرة أعدّل السيرة؟
الصياغة التي تناسب إعلانًا لا تناسب غيره دائمًا. في التجربة جعلتُ الكلمات الست مأخوذة من إعلان واحد، فلو كان الإعلان التالي يطلب «إعداد لوحات معلومات» لاحتجتُ إلى تعديل فقرة الملخص وسطرين في الخبرة فقط، لا سيرة جديدة. أحفظ نسخة أساسية بدون أي تعديل، وأطلب من الأداة نسخة جديدة لكل إعلان بنفس البرومبت، ثم أقارن النسختين بنفسي سطرًا بسطر. هذه المقارنة هي التي كشفت لي رقم «ثلاثة فروق» المضاف، ولو أرسلتُ النتيجة دون قراءة لمرّ الرقم.
كيف أطبق هذا على سيرتي أنا؟
إن أردتَ أن نُراجع سيرتك وإعلانات الوظائف التي تستهدفها معًا، وأن نبني ملفًا يخرج سليمًا بالعربية والإنجليزية، فيمكنك حجز جلسة ساعة كاملة معي. وهي تُخصم من أي مشروع ننفّذه معًا بعدها.