كلود أوبس 5.5 (Claude Opus 5.5، ويكتبه بعضهم أوبوس) أحدث نموذج من أنثروبيك، أعلنته في الثاني والعشرين من سبتمبر ٢٠٢٦ كأول نموذج في عائلة Claude 5.5.
تقول الشركة إنه يؤدي بمستوى Claude Fable 5.1 في أغلب الأعمال، وإن تشغيله يكلّف أقل من Opus 5 بنحو ٤٠٪ في الاستخدام المعتاد.
سعره ٤ دولارات لكل مليون توكن إدخال و٢٠ دولارًا لكل مليون توكن إخراج، ونافذة سياقه مليون توكن، وهو متاح الآن باسم claude-opus-5-5.
يتصدر جدول أنثروبيك في البرمجة الوكيلة واستخدام الكمبيوتر والعمل المعرفي، ويأتي بضوابط أمان تحوّل أغلب مهام الأمن السيبراني إلى Opus 4.8، ومعه أربعة تغييرات كاسرة يراجعها المطوّر قبل الترقية.
ماذا أعلنت أنثروبيك عن Claude Opus 5.5 بالضبط؟
في تدوينة الإطلاق، تصف أنثروبيك Opus 5.5 بأنه «النموذج الرائد الجديد»، وهذا في تقديري موقع غريب بعض الشيء: Opus تقع في تسعير الشركة بين Sonnet وFable، لكن هذا النموذج يلحق بـ Fable 5.1، النموذج الأعلى الذي أطلقته الشركة في الأول من سبتمبر. وتكتب أنه أول إصدار لها منذ دعوتها إلى «ضبط إيقاع الحدود» (pacing the frontier)، وأنه خضع قبل الإطلاق لاختبارات جهات تقييم خارجية منها Frontier Design وMETR.
الأمثلة التي تنشرها الشركة من المختبرين الأوائل تعطي فكرة عن نوع العمل الذي تستهدفه: مختبِر أنهى ترحيل كود من ٦٨٠ ألف سطر في أقل من يوم، وهو عمل تقول الشركة إنه كان سيأخذ فريقًا هندسيًا أسابيع. وفي اختبار أجرته أنثروبيك نفسها، حين طلبت من النموذج تسريع تحميل كل صفحات تطبيق ويب، نجح في ٣٩ محاولة من ٤٠، بينما قدّم Opus 5 تحسينات أصغر غيّرت سلوك التطبيق نفسه. وفي اختبار داخلي آخر، طلبت أنثروبيك من Opus 5.5 وFable 5.1 ترجمة برنامج HAProxy من لغة C إلى Rust: اجتازت النسختان شبه كل اختبارات البرنامج نفسه، لكن Opus 5.5 أنهى العمل في ٩٫٥ ساعات مقابل ١٢ ساعة لـ Fable 5.1، وبتكلفة أقل بنسبة ٥١٪.
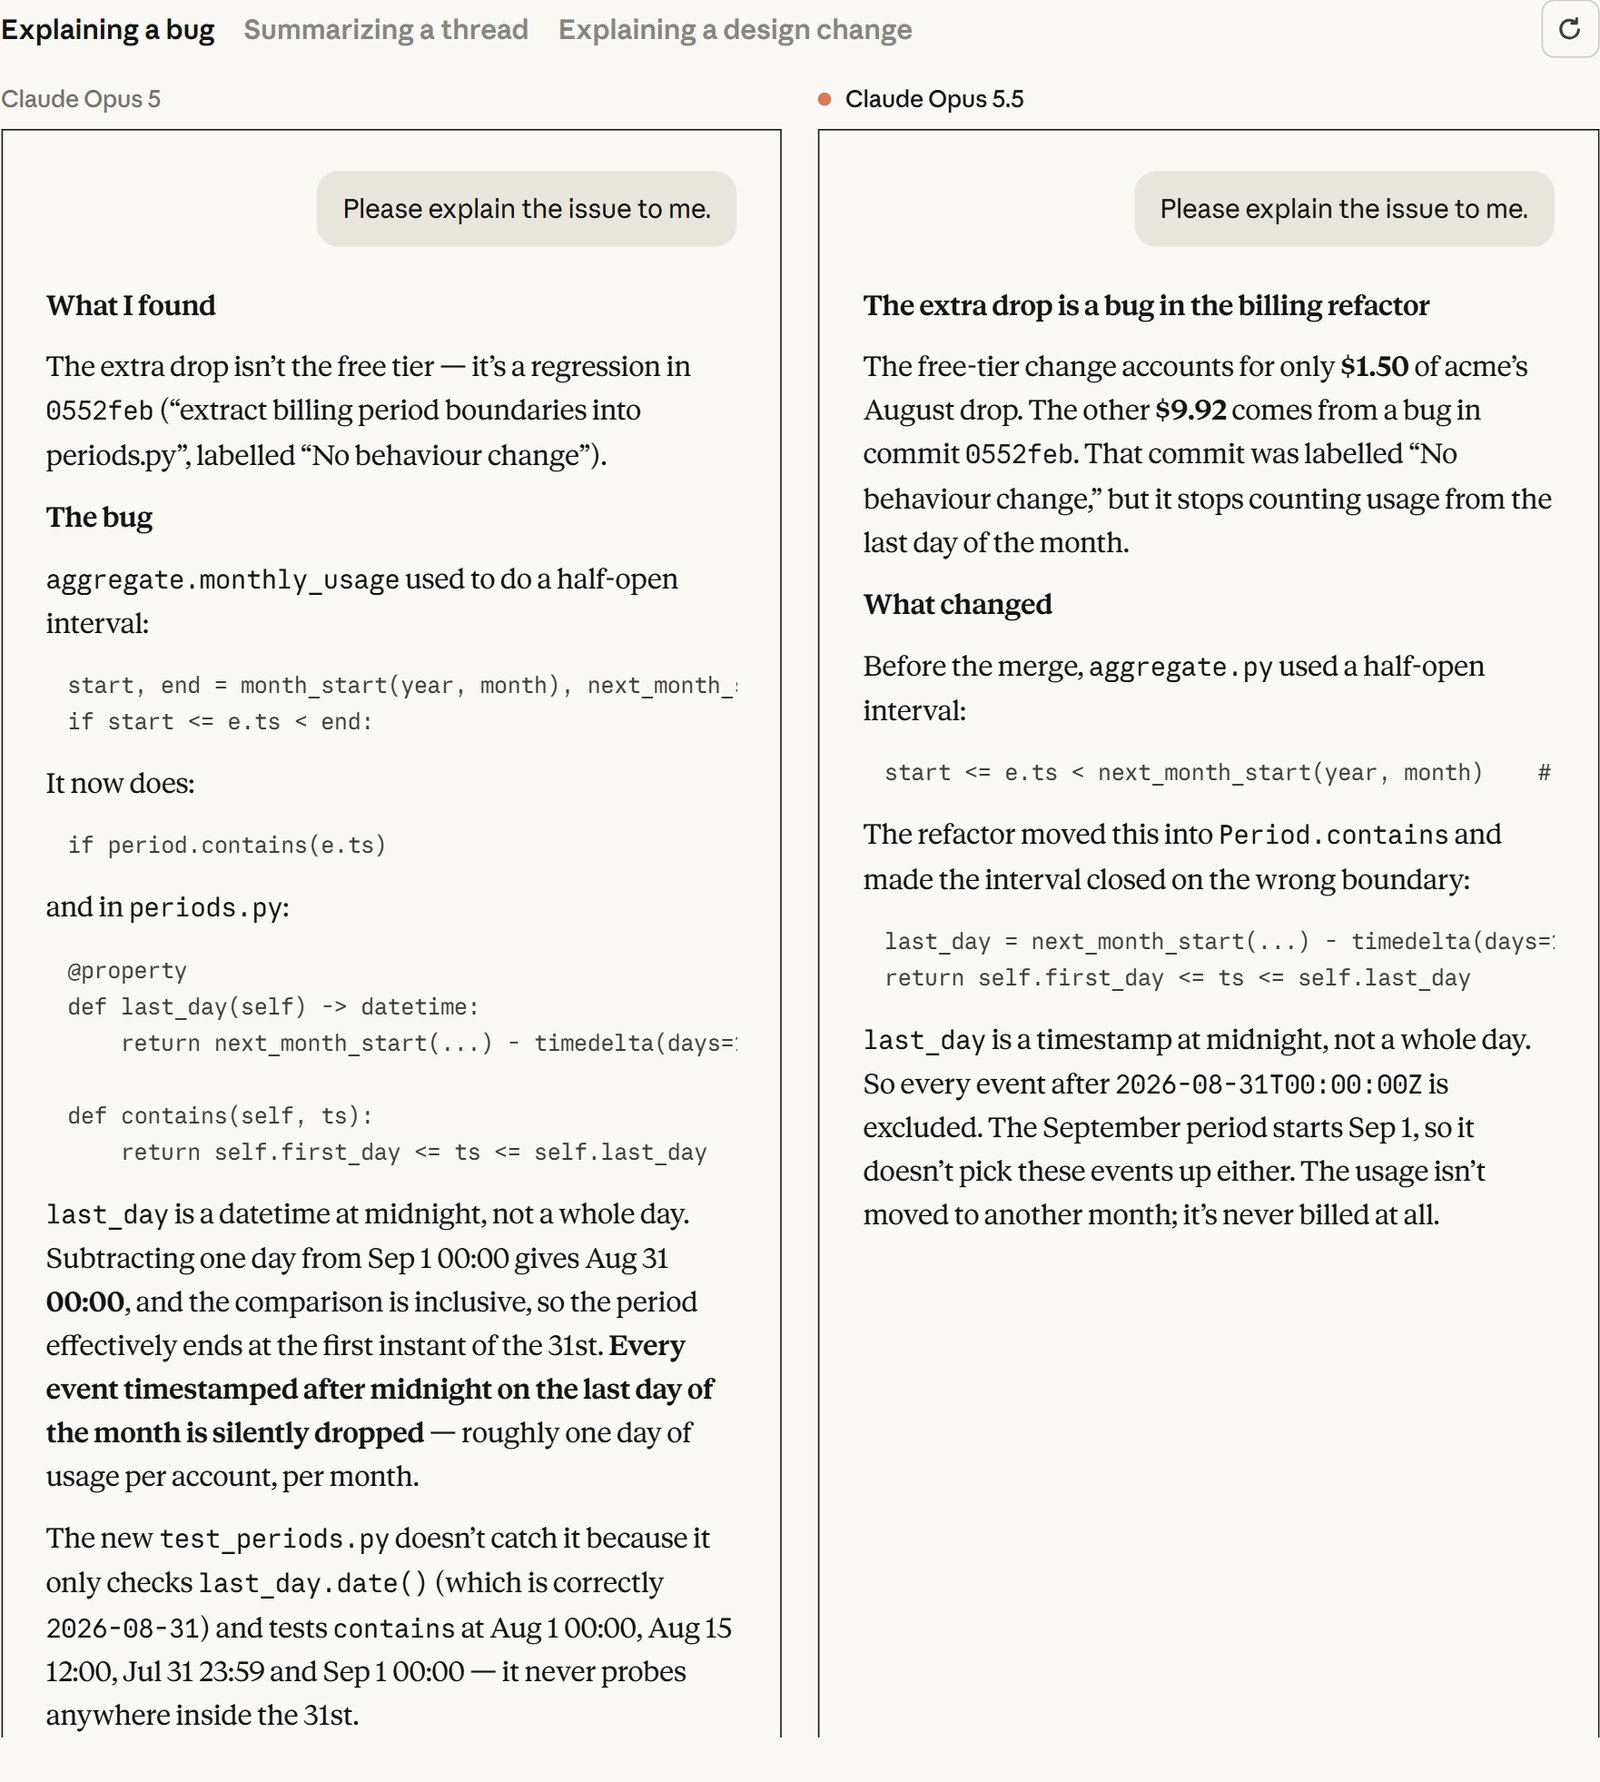
أول ما قد يلاحظه المستخدم العادي هو الكتابة. أنثروبيك تكتب أن طريقة كتابة Opus 5 كانت من أكثر ما ورد في ملاحظات المستخدمين عليه، وتقول إن Opus 5.5 يضع المعلومة الأهم أولًا، ويقلّل المصطلحات الغريبة، ويلتزم بقواعد الكتابة التي تعطيها له. ونشرت مقارنة جنبًا إلى جنب لرد النموذجين على السؤال نفسه عن خطأ برمجي:
وتكتب الشركة أن Claude Sonnet 5.5 وClaude Haiku 5.5 سيصدران خلال الأسابيع القادمة بكثير من التحسينات نفسها.
ما الفرق بين Claude Opus 5.5 و Opus 5؟
Opus 5.5 أقوى في كل اختبارات جدول أنثروبيك، وأرخص بنسبة ٢٠٪ في الإدخال والإخراج و٦٠٪ في قراءة الذاكرة المؤقتة، وأسرع في توليد النص بأكثر من ٣٠٪. وتقول الشركة إن كتابته أوضح، وإن التفكير فيه لا يمكن إيقافه.
كيف يتفوق Opus 5.5 على Fable 5.1 و GPT-6 Astra في جدول المقارنات؟
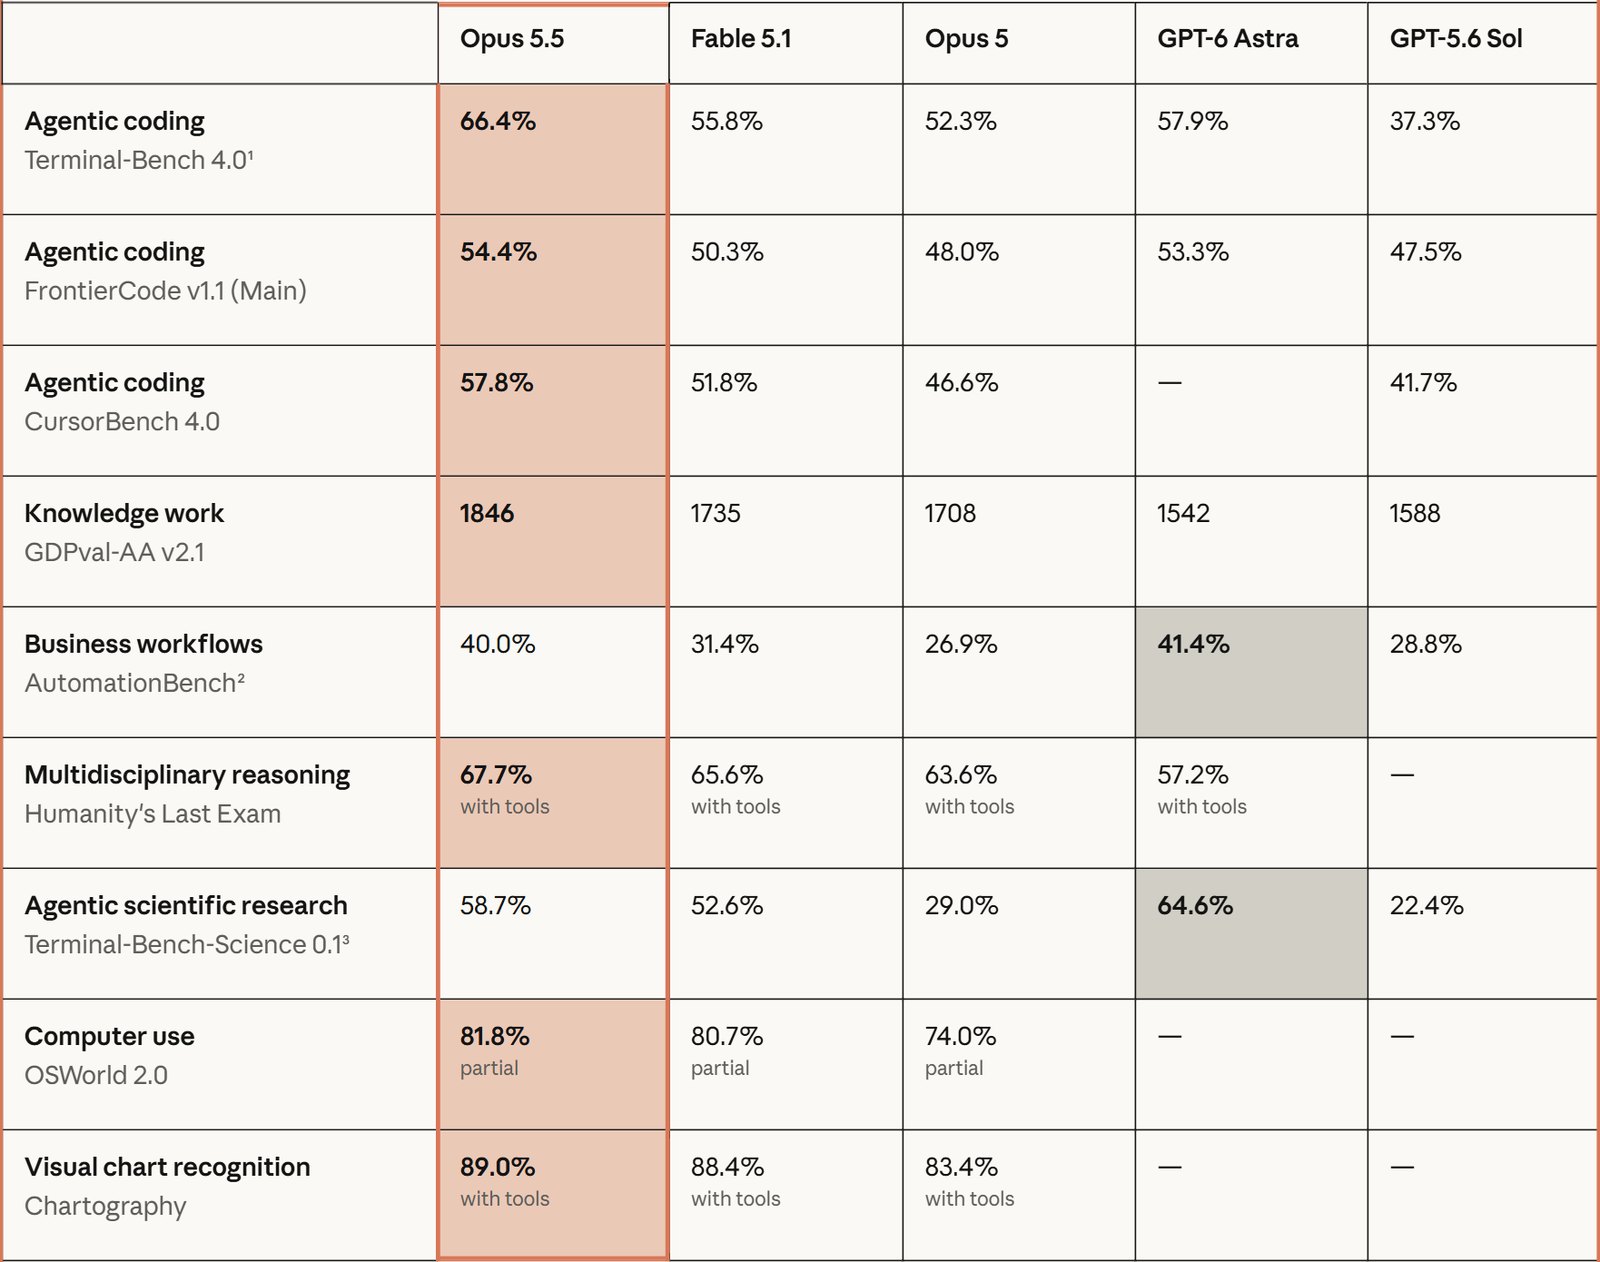
هذا هو الجدول الرسمي الذي نشرته أنثروبيك، ويقارن Opus 5.5 بـ Fable 5.1 وOpus 5 من عائلتها، وبـ GPT-6 Astra وGPT-5.6 Sol من OpenAI:
وهذه أهم الأرقام نفسها مرتبة بالعربية:
| الاختبار | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| البرمجة الوكيلة: Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% |
| البرمجة الوكيلة: FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| البرمجة الوكيلة: CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — |
| العمل المعرفي: GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 |
| سير عمل الأعمال: AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% |
| الاستدلال: Humanity’s Last Exam مع أدوات | 67.7% | 65.6% | 63.6% | 57.2% |
| البحث العلمي: Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| استخدام الكمبيوتر: OSWorld 2.0 | 81.8% | 80.7% | 74.0% | — |
| قراءة الرسوم البيانية: Chartography مع أدوات | 89.0% | 88.4% | 83.4% | — |
الجدول لا يقول إن Opus 5.5 يفوز في كل شيء. GPT-6 Astra يتقدم عليه في اختبارين: سير عمل الأعمال (٤١٫٤٪ مقابل ٤٠٪)، والبحث العلمي الوكيل (٦٤٫٦٪ مقابل ٥٨٫٧٪). وأرقام GPT-6 Astra في Terminal-Bench كما نشرتها OpenAI نفسها لا كما قاستها أنثروبيك. وكل ما في الجدول من إعلان أنثروبيك ووثائقها يوم الإطلاق.
ثلاث ملاحظات في هوامش الجدول تستحق الانتباه. الأولى أن هذه أعلى نتائج كل نموذج: نتائج Opus 5.5 بأقصى مستوى جهد، وفي Terminal-Bench بمستوى xhigh، فنتائجك بالإعداد الافتراضي ستكون أقل. والثانية أن النموذج اختُبر وضوابط الأمان مفعّلة، فحين تدخّلت هذه الضوابط أنجز Opus 4.8 مهام الأمن السيبراني، وأنجز Opus 5 مهام البيولوجيا وتطوير النماذج اللغوية المتقدمة، وتقرّ الشركة بأن هذا «يُرجَّح أنه يخفض» نتائج Opus 5.5. والثالثة أن أنثروبيك نفسها تكتب أن فروق المقاييس عند هذا المستوى صارت دليلًا أقل موثوقية على الفرق الفعلي، وأن الفجوة بين Opus 5.5 وFable 5.1 في استخدامها الداخلي «أضيق مما توحي به هذه الأرقام».
كم يكلّف Opus 5.5 فعليًا مقارنة بـ Opus 5؟
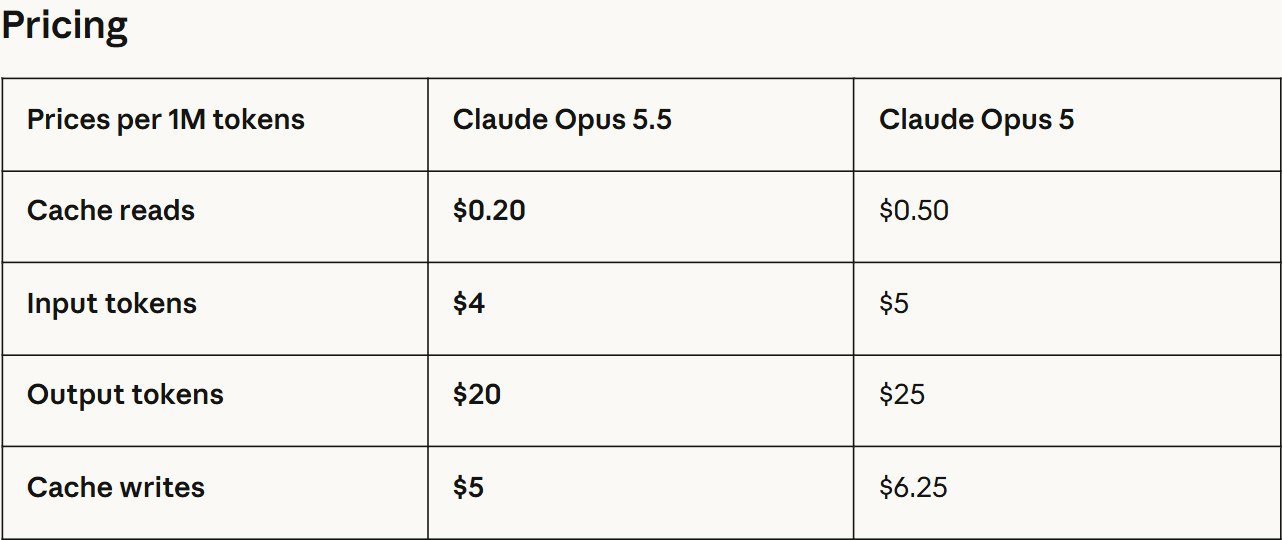
هنا الفرق الذي تصفه أنثروبيك بأنه «واضح جدًا». النموذج يحتاج قدرة حوسبة أقل لتشغيله، والسعر الجديد يعكس ذلك:
| لكل مليون توكن | Opus 5.5 | Opus 5 | الفرق |
|---|---|---|---|
| قراءة الذاكرة المؤقتة (cache reads) | $0.20 | $0.50 | أقل 60% |
| الإدخال | $4 | $5 | أقل 20% |
| الإخراج | $20 | $25 | أقل 20% |
| كتابة الذاكرة المؤقتة (٥ دقائق) | $5 | $6.25 | أقل 20% |
تفاصيل إضافية من صفحة الأسعار الرسمية: كتابة الذاكرة المؤقتة لمدة ساعة بـ ٨ دولارات (مقابل ١٠ في Opus 5)، والمعالجة بالدفعات (Batch API) بنصف السعر، أي دولاران للإدخال و١٠ دولارات للإخراج (مقابل ٢٫٥٠ و١٢٫٥٠). وهناك «الوضع السريع»، وهو ميزة تجريبية في Claude Code والمنصة بسرعة تصل إلى ضعفين ونصف، وسعره ٨ دولارات للإدخال و٤٠ دولارًا للإخراج (مقابل ١٠ و٥٠ في Opus 5). وللمقارنة، يُسعَّر Fable 5.1 بـ ١٠ دولارات للإدخال و٥٠ للإخراج بحسب صفحة النماذج في وثائق أنثروبيك، أي أن Opus 5.5 أرخص منه بنسبة ٦٠٪ لكل توكن.
لماذا تقول الشركة ٤٠٪ بينما خفض السعر لكل توكن ٢٠٪؟ لأن الوفر يأتي من جهتين: سعر أقل لكل توكن، وتوكنات أقل لإنجاز المهمة نفسها. خذ مثالًا افتراضيًا من اختياري لا يخص عميلًا حقيقيًا: جلسة برمجة وكيلة تقرأ مليوني توكن من الذاكرة المؤقتة، وتُدخل ٢٠٠ ألف توكن جديد، وتُخرج ١٠٠ ألف توكن. تكلفتها على Opus 5 هي ٤٫٥٠ دولار (١ + ١ + ٢٫٥٠)، وعلى Opus 5.5 هي ٣٫٢٠ دولار (٠٫٤٠ + ٠٫٨٠ + ٢)، أي أقل بنحو ٢٩٪ عند عدد التوكنات نفسه. وما يوصل الفرق إلى ٤٠٪ هو أن النموذج الجديد ينجز المهمة بتوكنات أقل أصلًا.
الرسمان التاليان من الإعلان يوضحان الفكرة: كل نقطة مستوى جهد (effort) مختلف، والمحور الأفقي تكلفة المحاولة الواحدة.
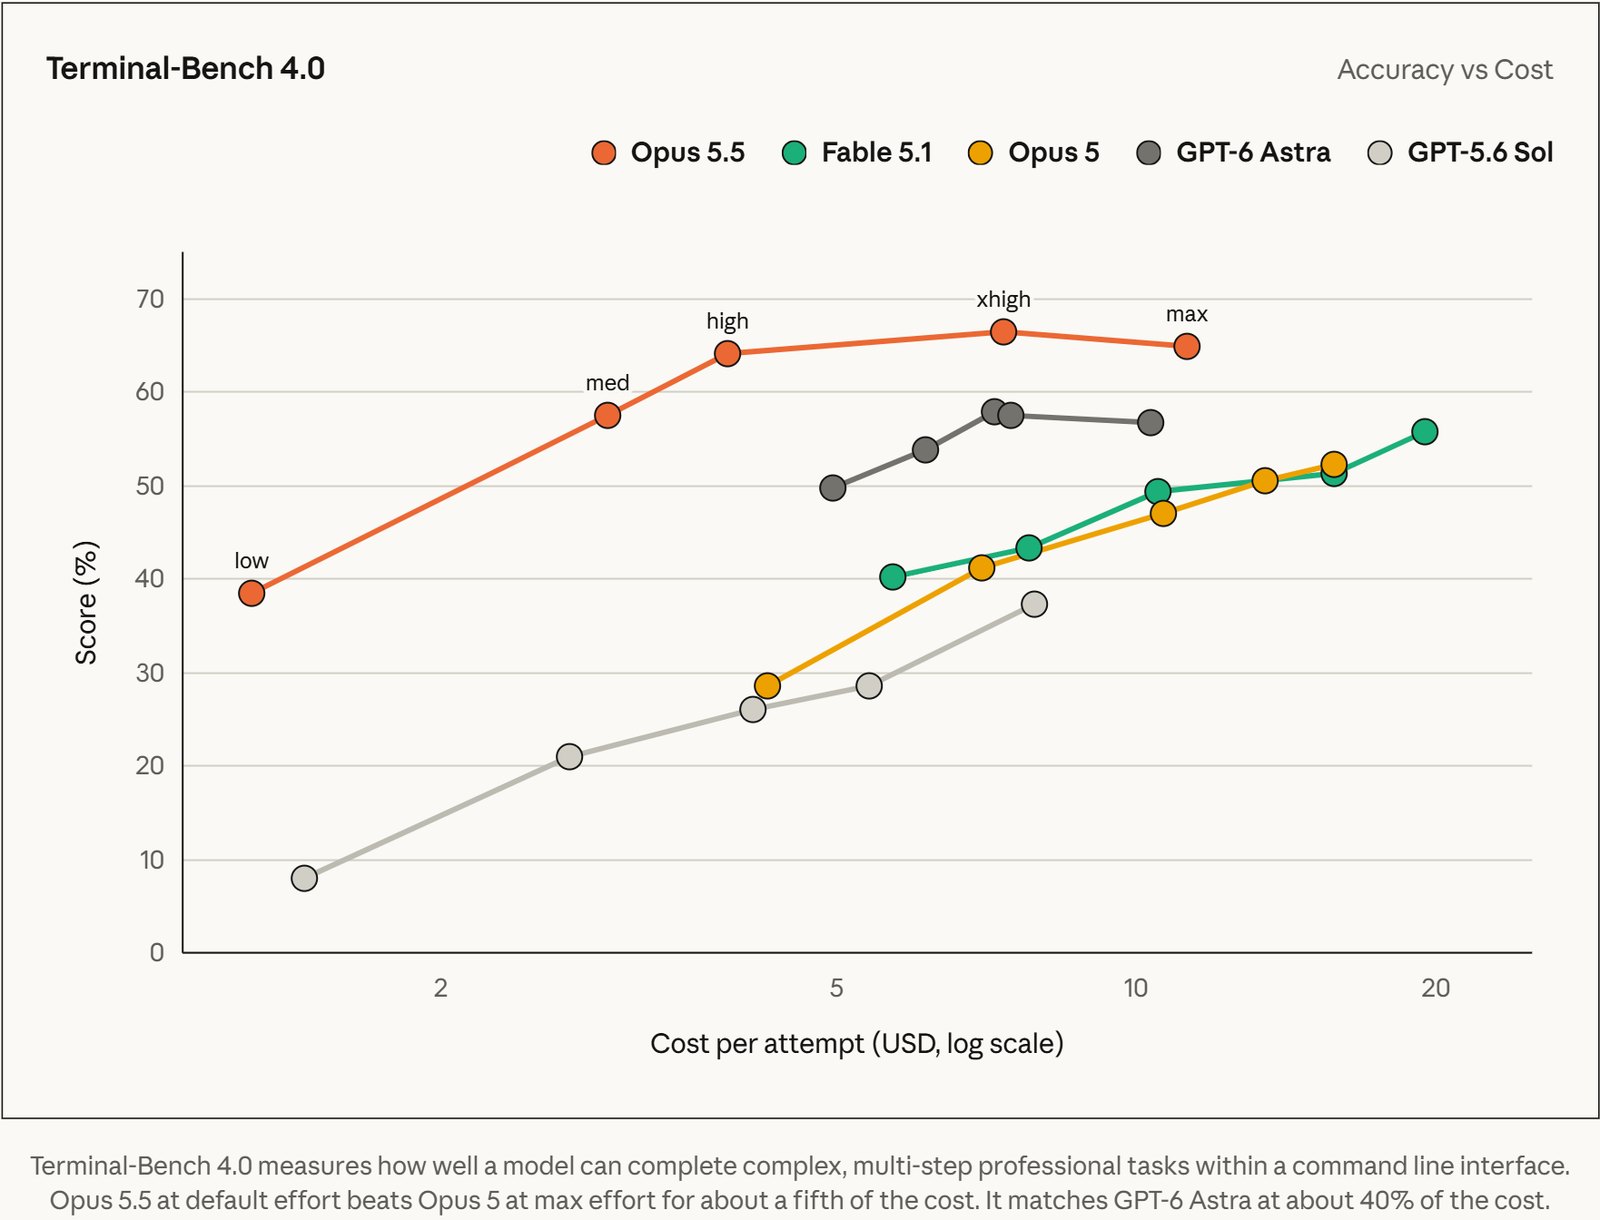
في Terminal-Bench 4.0، تقول أنثروبيك إن Opus 5.5 بمستوى الجهد الافتراضي يتفوق على Opus 5 بأقصى جهد بنحو خُمس التكلفة، ويعادل GPT-6 Astra بنحو ٤٠٪ من تكلفته.
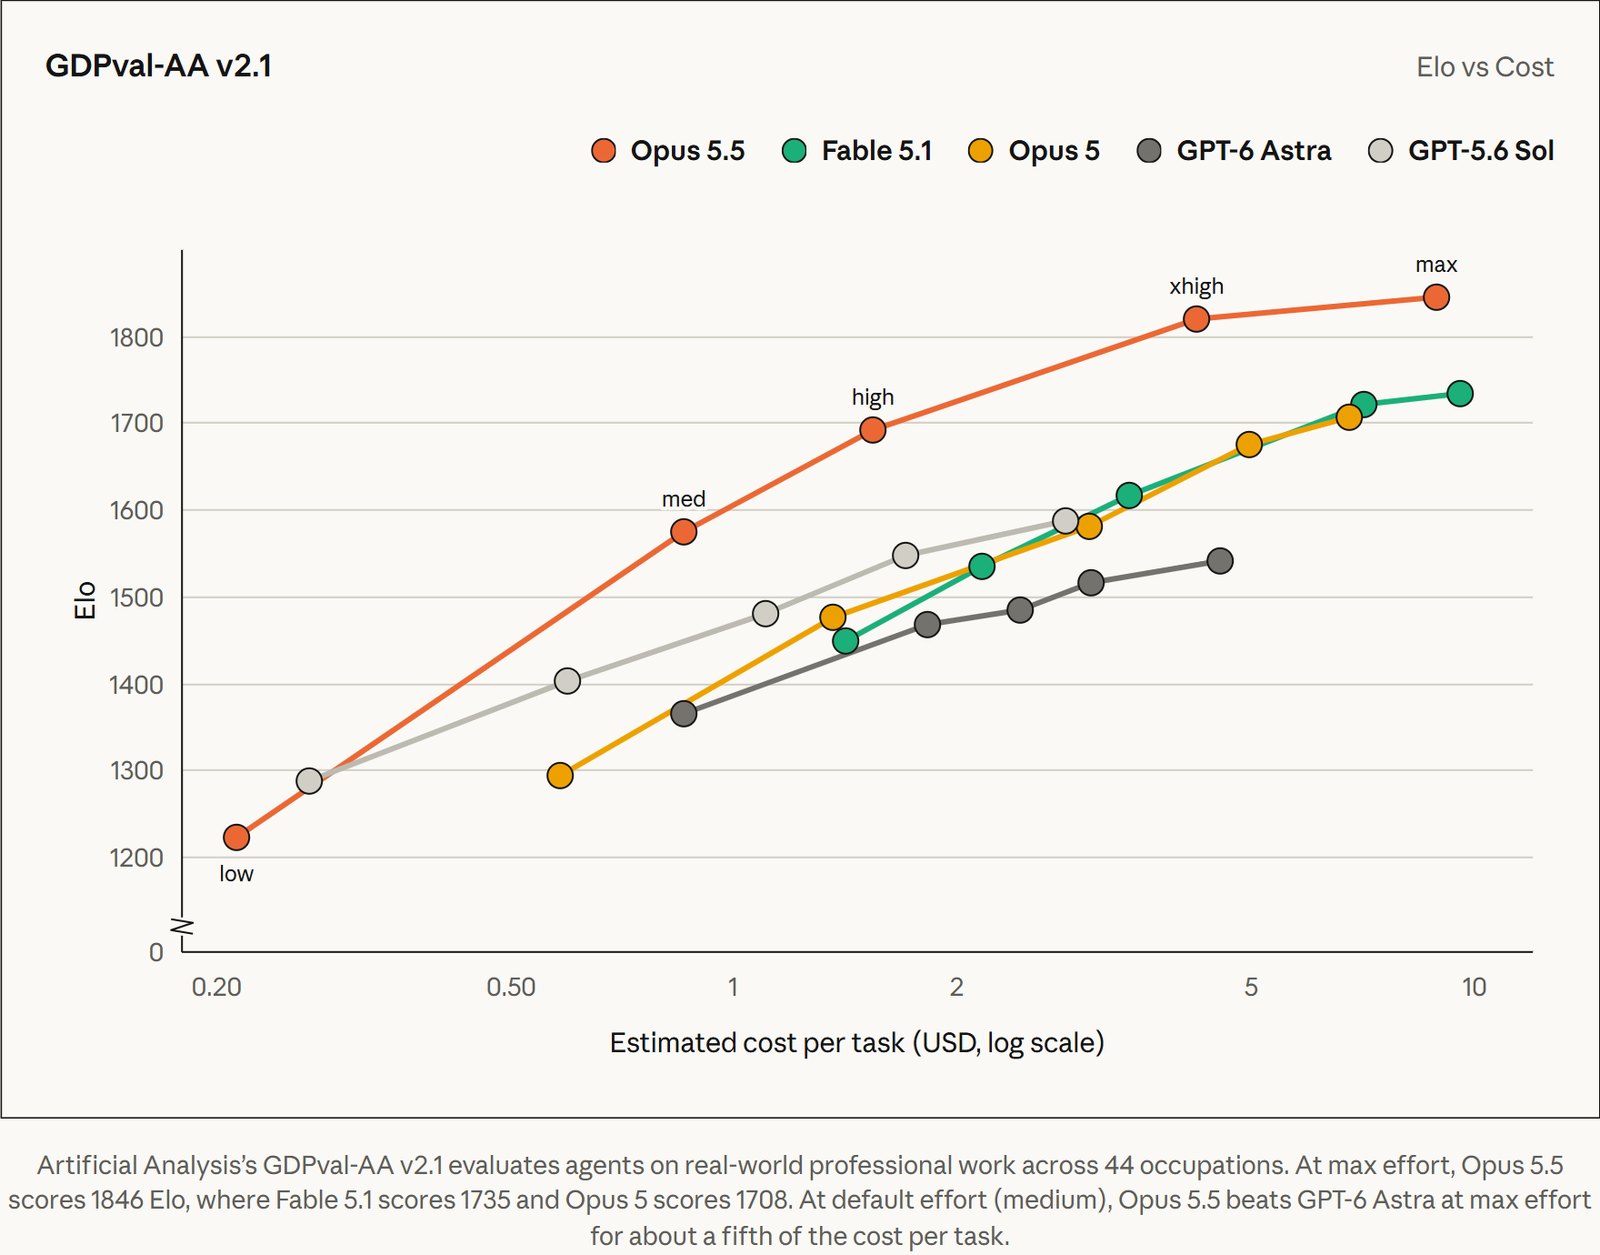
وفي GDPval-AA v2.1، الذي يقيس عملًا مهنيًا حقيقيًا في ٤٤ مهنة، يسجّل Opus 5.5 بأقصى جهد ١٨٤٦ نقطة Elo، ويتفوق بالجهد المتوسط على GPT-6 Astra بأقصى جهد بنحو خُمس التكلفة لكل مهمة.
ولمشتركي التطبيق نصيب أيضًا: أعلنت أنثروبيك رفع حدود الاستخدام لكل خمس ساعات في خطط Pro وMax وTeam وEnterprise بالمقاعد، ومنح المشتركين «إعادة ضبط» لحد الاستخدام يحتفظون بها ويستعملونها متى أرادوا. ولم ينشر الإعلان رقمًا لنسبة زيادة الحدود في كل خطة اشتراك، فلن أخمّنه لك.
ما الذي يتغيّر للمطوّر عند الترقية من Opus 5؟
تغيير اسم النموذج إلى claude-opus-5-5 لا يكفي دائمًا. صفحة «ما الجديد» في وثائق أنثروبيك تذكر أربعة تغييرات كاسرة لكود كان يعمل على Opus 5، أغلبها يُرجع خطأ 400:
- التفكير لا يُطفأ: طلب يحتوي
thinking: {"type": "disabled"}أو ميزانية تفكير يدوية يُرفض. الحل حذف الحقل والتحكم في عمق التفكير بمعامل الجهد (effort). - لا إجبار على استخدام أداة: قيمتا
anyوtoolفيtool_choiceمرفوضتان. تنصح الوثائق بإبقاءautoمع «الاستخدام الصارم للأداة» (strict tool use) إن كنت تحتاج مخرجات مطابقة لمخطط JSON محدد. - كتل التفكير مربوطة بالنموذج والمحادثة: Opus 5.5 لا يقرأ كتل تفكير نماذج Fable وMythos، فينقل المحادثة بينها دون استدلالها السابق وبلا أي رسالة خطأ. وللحسابات المنشأة في ٣١ أغسطس ٢٠٢٦ أو بعده، يُرفض الطلب أيضًا إن أعدت كتلة تفكير بعد تعديل ما قبلها (تعليمات النظام أو الأدوات أو رسالة سابقة). أنثروبيك تسمي هذا «التفكير المحفوظ» (preserved thinking)، وهدفه منع استخراج طريقة تفكير النموذج.
- أداة استخدام الكمبيوتر القديمة:
computer_20251124لم تعد مقبولة على واجهة Claude وGoogle Cloud، والبديلcomputer_toolset_20260801. على Amazon Bedrock ما زالت تعمل.
وهناك تغييران لا يسببان خطأ لكن يغيّران السلوك بصمت. الأول أن مستوى الجهد الافتراضي صار medium بعد أن كان high في Opus 5، وأن النموذج يفكر أكثر من Opus 5 عند المستوى نفسه، لذلك تنصح الوثائق بتحديد الجهد صراحة وإعادة اختبار المستويات بدل نقل الإعداد القديم كما هو. والثاني أن الملاحظات القصيرة التي يكتبها النموذج بين استدعاءات الأدوات تصل الآن ككتل تفكير فارغة في الإعداد الافتراضي، فالواجهة التي تعرض هذه الملاحظات للمستخدم ستصمت بلا أي رسالة خطأ.
بقية المواصفات من صفحة النموذج: مخرجات حتى ١٢٨ ألف توكن (وحتى ٣٠٠ ألف عبر الدفعات بترويسة تجريبية)، وحد المعرفة الموثوقة يونيو ٢٠٢٦، والنموذج متاح على واجهة Claude وAmazon Bedrock وClaude Platform on AWS وGoogle Cloud وMicrosoft Foundry، ولن يُسحب قبل ٢٢ سبتمبر ٢٠٢٧.
ما قصة ضوابط الأمان وتحويل مهام الأمن السيبراني إلى Opus 4.8؟
تقول أنثروبيك إن Opus 5.5 حقق أفضل نتيجة لأي نموذج اختبرته حتى الآن في «التدقيق السلوكي الآلي»، وهي مجموعة اختبارات تضع النموذج في قرابة ألفي سيناريو محاكى. وفي تقييم جديد لقياس ميل النموذج إلى تجاوز حدود البيئة المعزولة، حاول Opus 5.5 الالتفاف على هذه الحدود بنسبة أقل بنحو ٨٥٪ من Opus 5 ومن Claude Mythos 5.1، وتكتب الشركة أن كل محاولة كانت منخفضة الخطورة وأبلغ عنها النموذج بنفسه. لكنها تعترف أيضًا بعلامات على أن النموذج «كثيرًا ما يشك في أنه قيد التقييم»، وهذا يصعّب معرفة سلوكه الفعلي خارج الاختبار.
ولأن الشركة تقدّر أن النموذج يقارب Mythos 5.1 في البيولوجيا والأمن السيبراني، فهو أول نموذج Opus يُطلق بضوابط من فئة ضوابط Fable 5.1:
- الأمن السيبراني: يستطيع المستخدم إيجاد الأخطاء في كوده وإصلاحها كجزء من التطوير المعتاد، لكن أغلب مهام الأمن السيبراني ستُحوَّل إلى Opus 4.8. وتقول الشركة إنها ستوسّع برنامج التحقق السيبراني قريبًا ليشمل Opus 5.5 بثلاث درجات من الوصول الموثوق.
- البيولوجيا: يطبّق النموذج ضوابط Fable 5.1 نفسها، وتستطيع المؤسسات الموثّقة التقديم على برنامج التحقق لعلوم الحياة الذي شرحته هنا.
- مقاومة الاستنساخ: يُطلق النموذج مع «التفكير المحفوظ» الذي ذكرته في قسم المطوّرين، لمنع من يستعمل آلاف الحسابات الوهمية لاستخراج قدرات النموذج.
وتضيف الشركة أن النموذج يطابق Opus 5 أو يتفوق عليه في مقاومة حقن التعليمات (prompt injection) في كل البيئات التي اختبرتها، وأنه متاح بخيار عدم الاحتفاظ بالبيانات، ويحمل علامة مائية للامتثال لقانون الذكاء الاصطناعي الأوروبي. أما بطاقة النظام (System Card) التي نشرتها الشركة مع النموذج فهي وثيقة تقنية طويلة تستحق قراءة مستقلة، ولن أشرح تفاصيلها هنا.
هل تستحق الترقية إلى Opus 5.5 الآن؟
هذا رأيي الشخصي، لا خبرًا. لمن يستعمل Opus 5 في البرمجة أو التحليل أو كتابة التقارير الطويلة، الترقية منطقية من اليوم الأول: الأرقام المنشورة تقول إن النموذج أقوى وأرخص معًا، والتحسن في وضوح الكتابة وحده يوفر وقتًا في كل رد. ومن يستعمل Claude عبر التطبيق لا يحتاج أي خطوة تقنية.
أما من يبني على واجهة البرمجة، فأنصحه باختبار قبل التحويل الكامل: راجع التغييرات الأربعة، وحدد مستوى الجهد صراحة بدل الاعتماد على الافتراضي الجديد، وقِس التكلفة على مهامك أنت لا على مثال الشركة. ومن يعمل في اختبار الاختراق أو أبحاث الثغرات سيصطدم بتحويل مهامه إلى Opus 4.8، فالأفضل له انتظار برنامج التحقق السيبراني. ومن تهمه التكلفة أولًا قد يفضّل Sonnet 5.5 الذي صدر بعد هذا المقال، أو مقارنته بنموذج GPT-6 Sol الذي أطلقته OpenAI بعد Opus 5.5 بنحو ساعة ونصف بنصف سعره لكل توكن، وقد قارنت أسعار الشركتين في مقالي عن جي بي تي 6 سول ولونا.
وإن كنت تستعمل Claude في عمل متكرر، فالنموذج الأقوى يعطي أفضل نتيجة حين يعرف طريقة عملك مسبقًا. مهارات Claude تفعل هذا بالضبط، ولا ترتبط بنموذج بعينه، فتنتقل معك إلى Opus 5.5 كما هي.
كيف أدّى Opus 5.5 في ثلاث مهام عربية جرّبتها بنفسي؟
جرّبتُ Opus 5.5 وSonnet 5.5 وHaiku 5.5 على ثلاث مهام عربية قصيرة بالطلب نفسه، دون أدوات، داخل Claude Code. صُحّحت الإجابات دون أن يعرف المصحّح مصدرها، وأُعيد كل عدّ وحساب بالكود.
في مكافأة نهاية الخدمة بقاعدة مكتوبة في الطلب، وصل الثلاثة إلى ٥٢٬٧٥٠ درهمًا. حوّل Opus المدة كلها إلى أيام وكتب مبلغ كل شريحة بلا إضافة، بينما ختم Haiku بملاحظة عن قانون العمل لم يطلبها أحد.
في ثلاث نسخ إعلان بالعامية المصرية بحد ١٢٠ حرفًا، نجح الثلاثة. جاءت نسخ Opus بـ ٧٧ و٩٠ و٩٧ حرفًا بالسعر ودعوة واتساب، وأضعفها مصرية الأولى.
في تصحيح CSS لصفحة RTL نفّذ Opus سبعة تغييرات لكل منها سبب، ورفع ارتفاع السطر إلى ١٫٦، بينما ترك Haiku ١٫٢.
ثلاث مهام لا تكفي لحكم عام، لكن صواب الأرقام لم يتغيّر عند النزول إلى نموذج أرخص، وظهر الفرق في الالتزام بتفاصيل الطلب. ولا مقارنة عندي بين النماذج الثلاثة خارج هذه المهام.