كلود سونت 5.5 (Claude Sonnet 5.5، ويكتبه بعضهم سونيت) نموذج أعلنته أنثروبيك في الثامن والعشرين من سبتمبر ٢٠٢٦، وهو الثاني في عائلة Claude 5.5 بعد Opus 5.5.
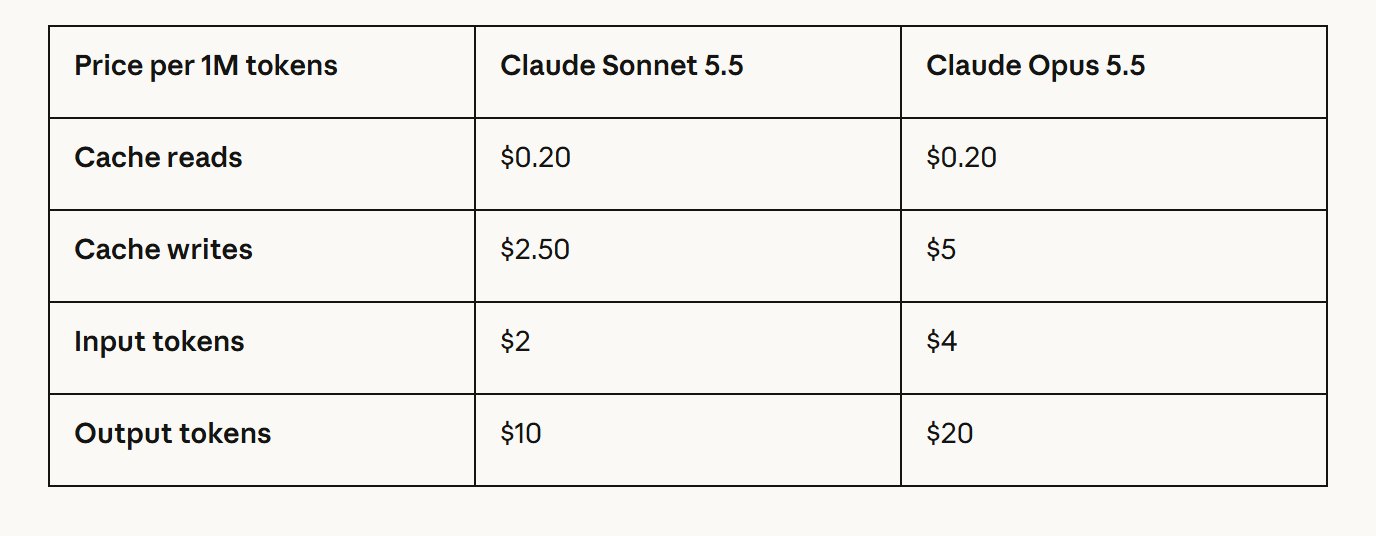
سعره لم يتغير عن Sonnet 5: دولاران لكل مليون توكن إدخال و١٠ دولارات لكل مليون توكن إخراج، أي نصف سعر Opus 5.5، ونافذة سياقه مليون توكن.
تقول الشركة إنه أسرع من Sonnet 5 بأكثر من ٣٠٪، وإن المهمة الواحدة عليه تكلّف أقل بما يصل إلى ٣٠٪ لأنه ينجزها بتوكنات أقل.
في جدولها الرسمي سجّل ٧٠٫٦٪ في اختبار Terminal-Bench 4.0 للبرمجة الوكيلة مقابل ١٠٫٣٪ لسابقه، واقترب من Opus 5.5 في أغلب الاختبارات الأخرى.
وهو متاح الآن في تطبيقات Claude وClaude Code وواجهة البرمجة باسم claude-sonnet-5-5.
ماذا أعلنت أنثروبيك عن Claude Sonnet 5.5؟
لا تقدّم أنثروبيك النموذج بديلًا لـ Opus 5.5، بل مكمّلًا أسرع وأرخص له: Opus 5.5 للعمل المعقد الذي يحتاج حكمًا دقيقًا، وSonnet 5.5 للمهام اليومية محددة النطاق، وإصلاح الأخطاء البرمجية، وإعداد المستندات والعروض وجداول البيانات. وتكتب الشركة أن كتابته أوضح من الجيل السابق، وأن له عينًا حادة في التصميم، وأن المختبرين وجدوه يلتزم بقوالب العروض فتخرج الشرائح بأقل تعديل. أما Claude Haiku 5.5 فسيصدر خلال الأسابيع القادمة.
أطرف ما في الإعلان أنه أول نموذج Sonnet ينهي لعبة Pokémon Red وهو لا يرى منها إلا لقطات الشاشة. وفي اختبار داخلي أقرب إلى عمل المكاتب، طلبت منه أنثروبيك مراجعة تشغيلية من ١٠ شرائح لشركة مدرجة، انطلاقًا من مواد نتائجها الفصلية ونصوص مكالمات الأرباح وقالب عروض، فحكم خبيران بأن مسودته الأولى جاهزة للإرسال كما هي.
أما السرعة فتعرضها صفحة الإعلان بمقارنة حية: الأمر نفسه يُعطى للنموذجين، وهو كتابة محاكاة لسرب من ٤٠٠ طائر زرزور في ملف HTML واحد.
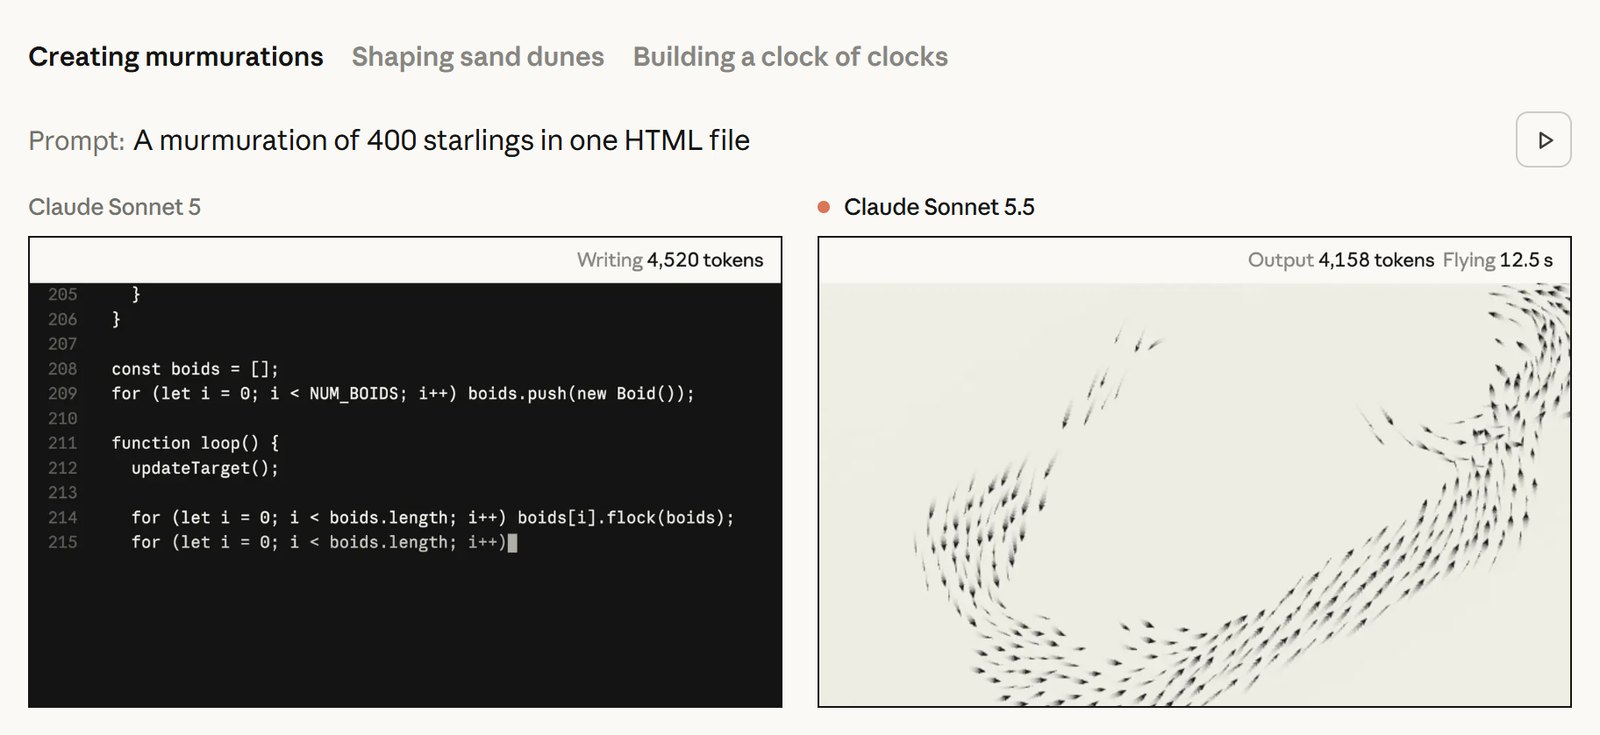
في هذه اللقطة كان Sonnet 5 قد كتب ٤٥٢٠ توكنًا ولم ينتهِ، بينما أنهى Sonnet 5.5 عمله كله بـ ٤١٥٨ توكنًا، أي بأقل مما كتبه سابقه حتى تلك اللحظة، ومن هنا يأتي التوفير.
متى صدر Claude Sonnet 5.5؟
أعلنته أنثروبيك في ٢٨ سبتمبر ٢٠٢٦، وصار متاحًا في اليوم نفسه في تطبيقات Claude وClaude Code وواجهة البرمجة وAmazon Bedrock وGoogle Cloud وMicrosoft Foundry.
جدول المقارنات: أين يقترب سونت 5.5 من Opus 5.5؟
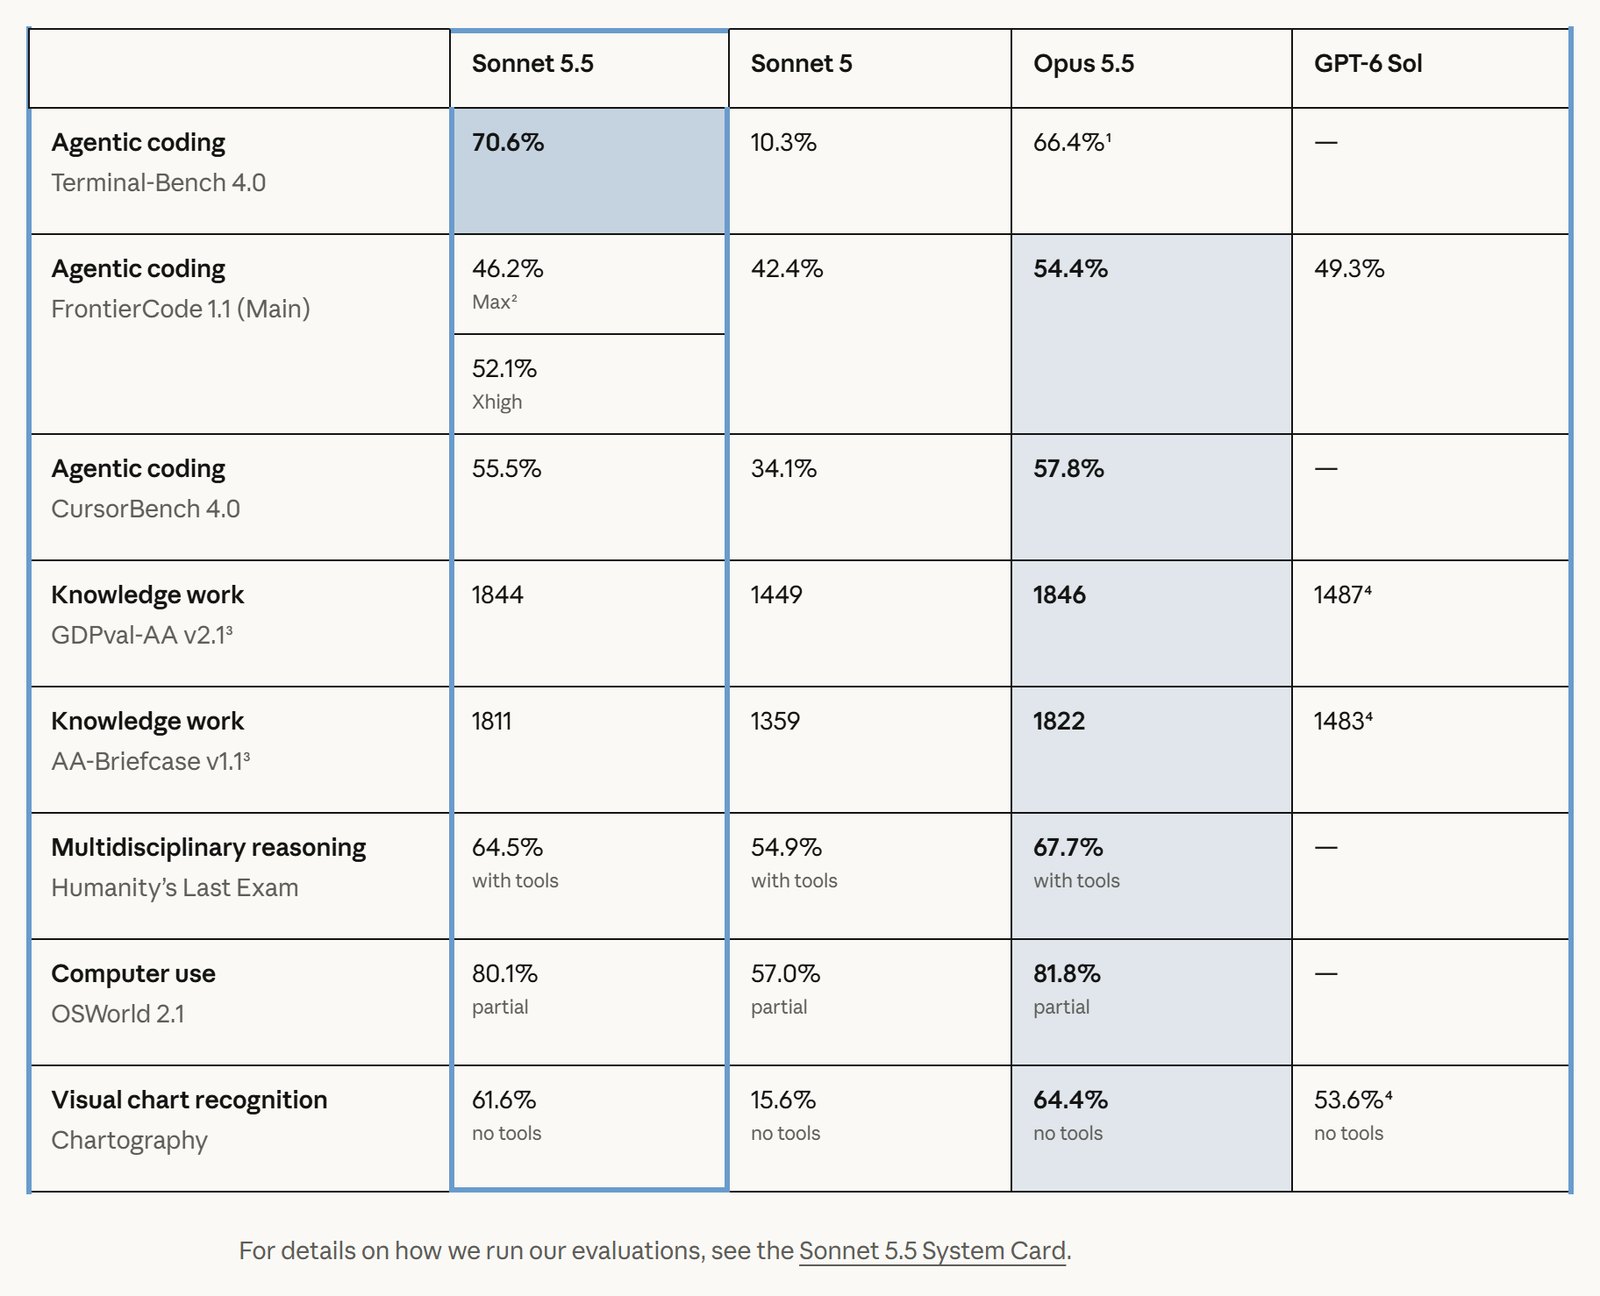
هذا الجدول الرسمي كما نشرته أنثروبيك، ويقارن Sonnet 5.5 بسابقه، وبـ Opus 5.5، وبنموذج GPT-6 Sol من OpenAI الذي يطابقه في السعر:
وهذه الأرقام نفسها مرتبة بالعربية:
| الاختبار | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| البرمجة الوكيلة: Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | — |
| البرمجة الوكيلة: FrontierCode 1.1 | 52.1% / 46.2% | 42.4% | 54.4% | 49.3% |
| البرمجة الوكيلة: CursorBench 4.0 | 55.5% | 34.1% | 57.8% | — |
| العمل المعرفي: GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| العمل المعرفي الطويل: AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| الاستدلال: Humanity’s Last Exam مع أدوات | 64.5% | 54.9% | 67.7% | — |
| استخدام الكمبيوتر: OSWorld 2.1 | 80.1% | 57.0% | 81.8% | — |
| قراءة الرسوم البيانية: Chartography بلا أدوات | 61.6% | 15.6% | 64.4% | 53.6% |
في صف FrontierCode، الرقم الأول لـ Sonnet 5.5 نتيجته بمستوى الجهد xhigh، والثاني بأقصى جهد (max). ورقم Opus 5.5 في Terminal-Bench بمستوى xhigh، وهو أعلى نتائجه.
القفزة الأكبر في Terminal-Bench 4.0، من ١٠٫٣٪ إلى ٧٠٫٦٪، وهي أعلى حتى من ٦٦٫٤٪ التي سجلها Opus 5.5. وفي GDPval-AA، الذي يختبر مهام عمل حقيقية في ٤٤ مهنة، جاء على بعد نقطتين من Opus 5.5 وفوق Sonnet 5 بنحو ٤٠٠ نقطة. لكن أنثروبيك نفسها تحذّر من قراءة الجدول وحده: في اختباراتها واختبارات جهات خارجية، يبقى Opus 5.5 أقوى بوضوح في العمل المعقد المفتوح الذي يحتاج حكمًا متواصلًا. وفي هوامش الجدول ثلاث ملاحظات:
- نتيجة FrontierCode بأقصى جهد أقل منها بمستوى xhigh. الاختبار يعاقب أي تعديل خارج نطاق المهمة، والنموذج بأقصى جهد كان يشغّل أكثر مهارة مراجعة الكود في Claude Code، وهي توزّع المراجعة على وكلاء فرعيين كثيرين، فانتهت حالتان فحصتهما Cognition بتجاوز الوقت أو بتعديلات زائدة عن المطلوب.
- اختبارا GDPval-AA وAA-Briefcase أجرتهما Artificial Analysis على نسخة ما قبل الإطلاق، وكان فيها خلل في المخرجات المنظمة (structured outputs) أُصلح لاحقًا. تتوقع الشركة أن أثره صغير، وأنه يخفض النتيجة لا يرفعها.
- أصلحت OpenAI مؤخرًا خللًا في فهم الصور لدى GPT-6 Sol، فقد لا تعكس أرقامه في GDPval-AA وAA-Briefcase وChartography نسخته الحالية.
رسم FrontierCode يُظهر الملاحظة الأولى، ومعها ما يهم من يدفع الفاتورة:
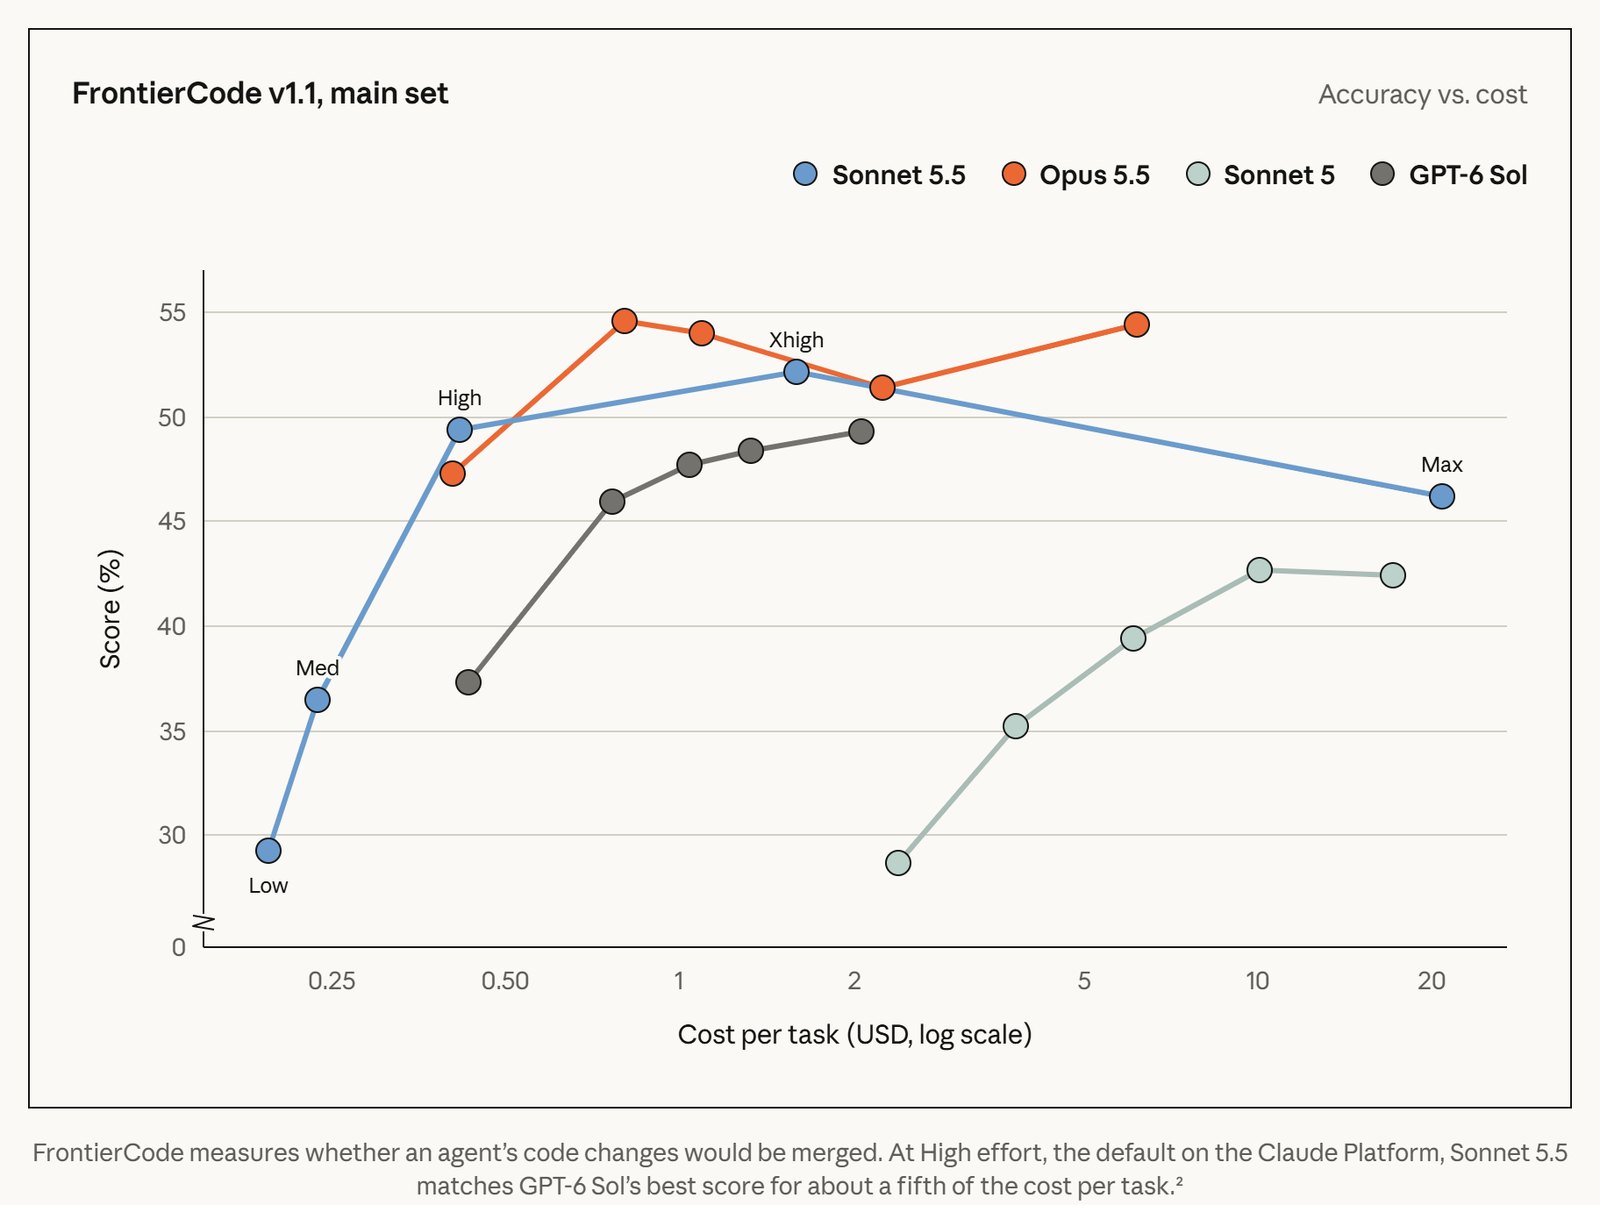
بمستوى الجهد high، وهو الافتراضي على منصة Claude للمطورين، يعادل Sonnet 5.5 أفضل نتيجة لـ GPT-6 Sol في هذا الاختبار بنحو خُمس التكلفة لكل مهمة. وبالمستوى نفسه يتفوق على Sonnet 5 بعشر نقاط، بنحو جزء من خمسة عشر من تكلفته.
كم يكلّف سونت 5.5 فعليًا مقارنة بـ Opus 5.5؟
| لكل مليون توكن | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| الإدخال | $2 | $4 |
| الإخراج | $10 | $20 |
| قراءة الذاكرة المؤقتة | $0.20 | $0.20 |
| كتابة الذاكرة المؤقتة (٥ دقائق) | $2.50 | $5 |
| كتابة الذاكرة المؤقتة (ساعة) | $4 | $8 |
| إدخال المعالجة بالدفعات | $1 | $2 |
| إخراج المعالجة بالدفعات | $5 | $10 |
الأسعار كلها مطابقة لـ Sonnet 5، ونافذة المليون توكن تُحاسَب كاملة بالسعر العادي.
عبارة «نصف السعر» صحيحة في الإدخال والإخراج، لكنها لا تنطبق على قراءة الذاكرة المؤقتة، وسعرها ٢٠ سنتًا في النموذجين. وهذا يهم لأن جلسات الوكلاء تقرأ من الذاكرة المؤقتة أكثر بكثير مما تكتب. خذ المثال الافتراضي نفسه الذي استعملته في مقالي عن Opus 5.5، وهو من اختياري لا من فاتورة عميل: جلسة برمجة تقرأ مليوني توكن من الذاكرة المؤقتة، وتُدخل ٢٠٠ ألف توكن جديد، وتُخرج ١٠٠ ألف توكن. تكلفتها على Opus 5.5 هي ٣٫٢٠ دولار (٠٫٤٠ + ٠٫٨٠ + ٢)، وعلى Sonnet 5.5 هي ١٫٨٠ دولار (٠٫٤٠ + ٠٫٤٠ + ١)، أي أقل بنحو ٤٤٪ لا ٥٠٪. والمبلغ نفسه ينطبق على GPT-6 Sol، لأن OpenAI تسعّره بالأرقام نفسها، لكن سعره يرتفع في طلبات السياق الطويل إلى ٤ دولارات للإدخال و١٥ للإخراج.
الجزء الثاني من التوفير يأتي من عدد التوكنات، وهذا ما ترسمه أنثروبيك: كل نقطة مستوى جهد مختلف، وكلما اقتربت من أعلى اليسار زادت القدرة مقابل كل دولار.
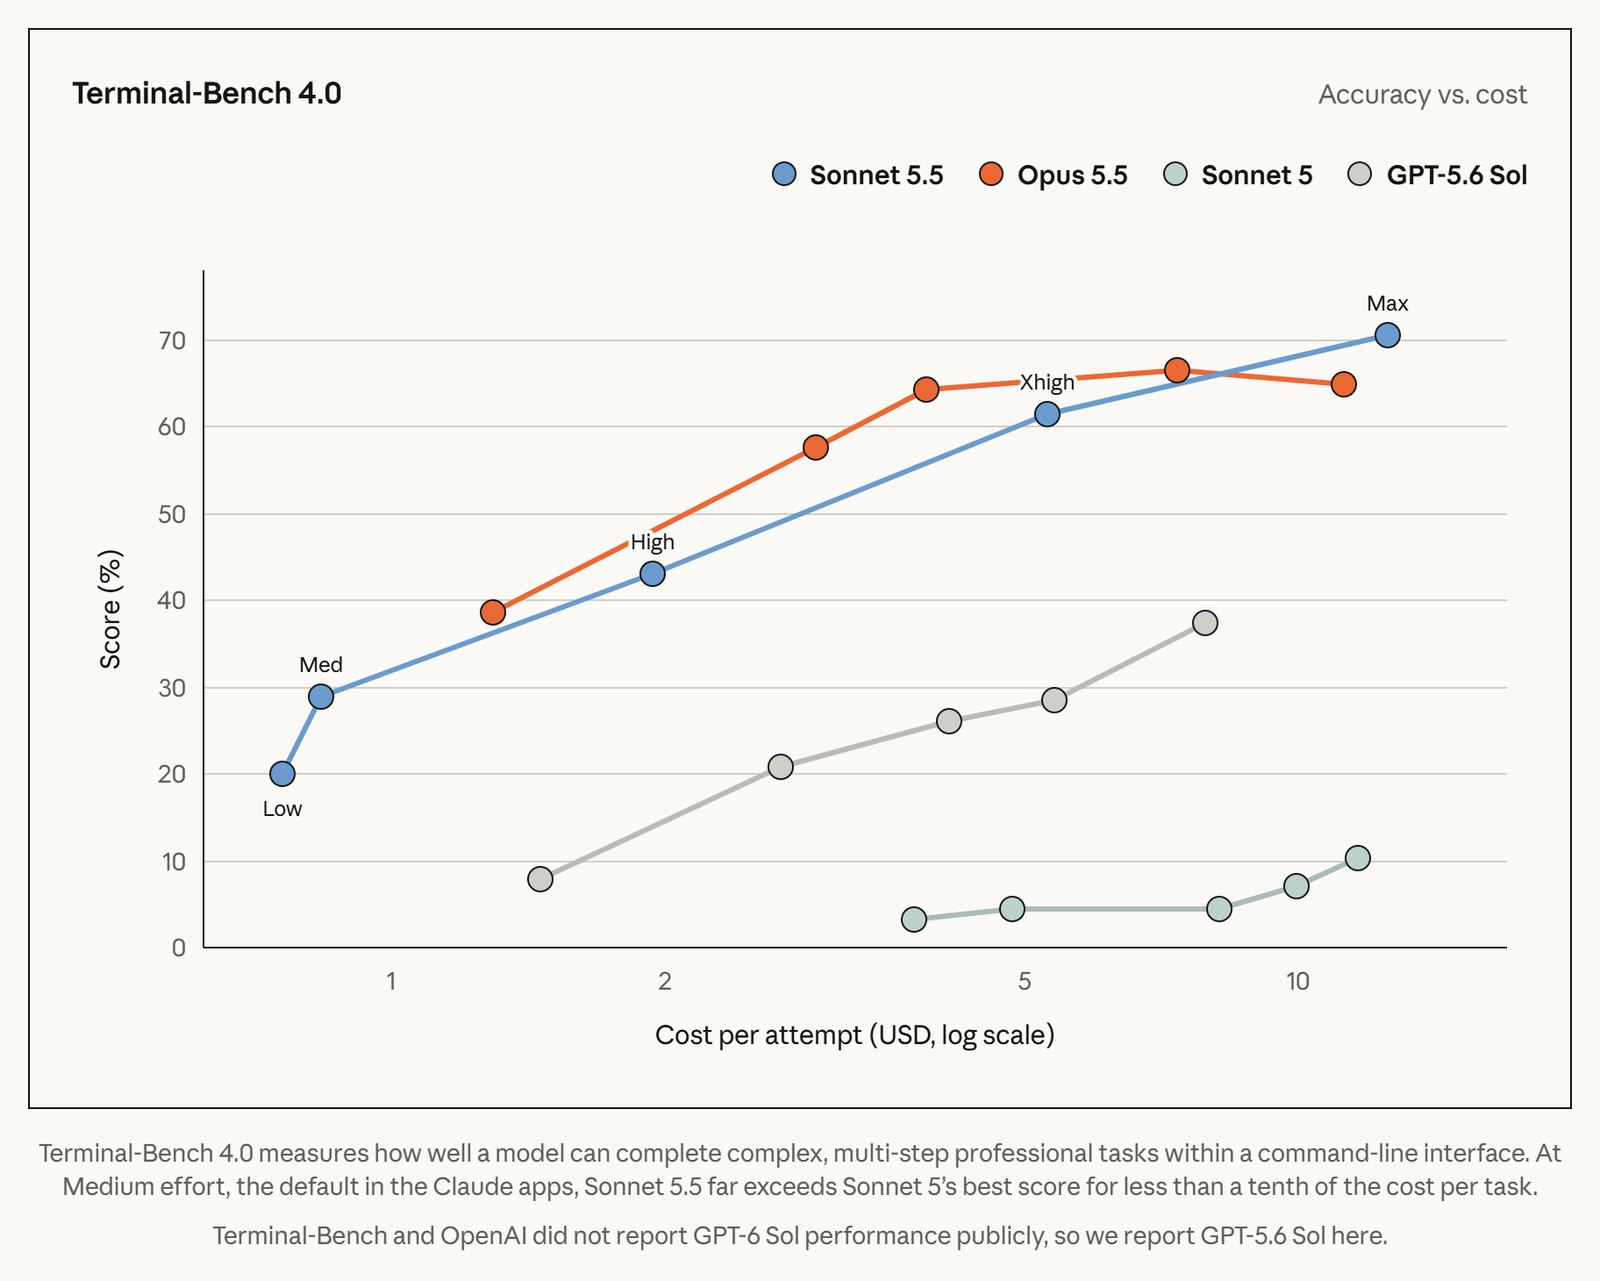
بالجهد المتوسط، وهو الافتراضي في تطبيقات Claude، يتجاوز Sonnet 5.5 أفضل نتيجة حققها Sonnet 5 بأقل من عُشر التكلفة لكل مهمة. لكن انظر أين تقع نتيجة ٧٠٫٦٪ التي تتصدر الجدول: هي النقطة الأبعد يمينًا في الرسم، بأقصى جهد، وتكلفة المحاولة فيها أعلى من أي نقطة لـ Opus 5.5، بينما نقطة الجهد المتوسط عند نحو ٣٠٪. الرقم الكبير حقيقي، لكنه نتيجة أغلى إعداد لا الإعداد الافتراضي. وفي الرسم GPT-5.6 Sol بدل GPT-6 Sol، لأن نتيجة الأخير في هذا الاختبار لم تُنشر.
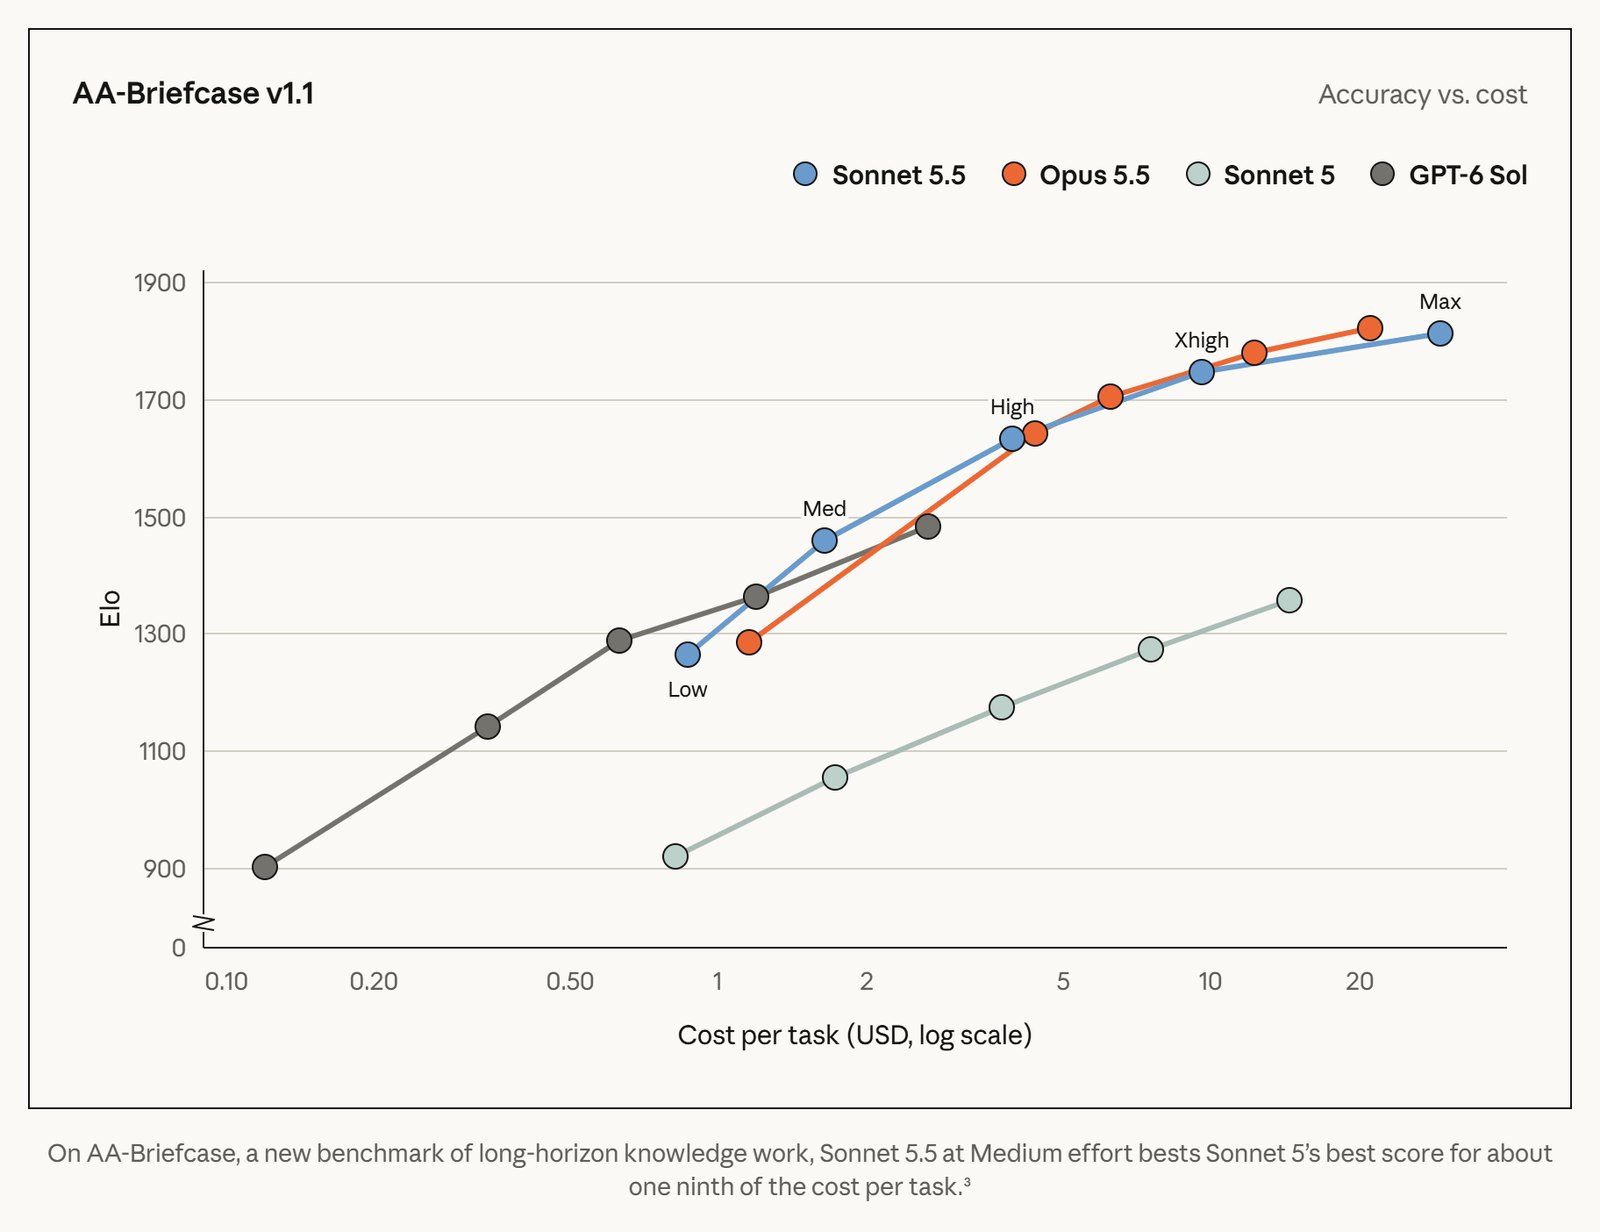
وفي AA-Briefcase، وهو اختبار جديد للعمل المعرفي طويل المدى، يتفوق Sonnet 5.5 بالجهد المتوسط على أفضل نتيجة لـ Sonnet 5 بنحو تُسع التكلفة لكل مهمة.
وأرقام العملاء الأوائل في الإعلان تسير في الاتجاه نفسه. تقول Balyasny Asset Management إنه استهلك نحو ١٢١ ألف توكن لكل إجابة في ٢٤٤١ مهمة مالية، مقابل ٤٩٧ ألفًا لـ Sonnet 5. وتقول Box إنه كان أدق من سابقه وأسرع منه ٢٫٤ مرة، واستهلك توكنات أقل بنسبة ١٢٪.
ما الذي يتغير للمطوّر عند الانتقال من Sonnet 5؟
تغيير اسم النموذج إلى claude-sonnet-5-5 لا يكفي دائمًا. وثائق أنثروبيك تذكر خمسة تغييرات كاسرة لكود كان يعمل على Sonnet 5، وأغلبها يُرجع خطأ 400:
- إطفاء التفكير بالقيمة
disabledمرفوض، والبديل الجديدbetween_toolsالذي يلغي التفكير المسبق ويُبقي ملاحظات قصيرة بين استدعاءات الأدوات. يعمل بمستوى الجهدhighفما دونه، أماxhighوmaxفيحتاجان التفكير التكيفي (adaptive). - إجبار النموذج على استخدام أداة بالقيمتين
anyوtoolفيtool_choiceمرفوض. أبقِautoمع الاستخدام الصارم للأداة (strict tool use)، واكتب في التعليمات متى تنطبق الأداة. - كتل التفكير مربوطة بالنموذج والمحادثة. Sonnet 5.5 يقرأ كتل Sonnet 5 وOpus 4.8 وHaiku 4.5، ولا يقرأ كتل Opus 5 وOpus 5.5 وFable وMythos، والكتل غير المقروءة تُحذف بصمت. وللحسابات المنشأة في ٣١ أغسطس ٢٠٢٦ أو بعده، يُرفض الطلب إن أعدت كتلة تفكير بعد تعديل ما قبلها، فاجعل المحادثة تنمو بالإضافة فقط.
- أداة استخدام الكمبيوتر القديمة
computer_20251124مرفوضة على واجهة Claude وGoogle Cloud، والبديلcomputer_toolset_20260801، بينما ما زالت Amazon Bedrock تقبلها. - أداة المستشار (advisor) لم تعد تقبل Opus 4.8 أو Opus 4.7 أو Sonnet 5 مستشارًا حين يكون Sonnet 5.5 هو المنفّذ. المقبول Opus 5.5 وOpus 5 ونماذج Fable وMythos، أو Sonnet 5.5 نفسه.
وهناك تغيير لا يسبب خطأ لكنه يغيّر شكل الرد: الملاحظات الطويلة التي يكتبها النموذج بين استدعاءات الأدوات تصل الآن ككتل تفكير نصها فارغ في الإعداد الافتراضي، فالواجهة التي تعرضها للمستخدم ستصمت بلا أي رسالة خطأ. الحل أن تحدد قيمة display مع التفكير التكيفي، أو أن تستعمل between_tools الذي يعيد النص.
وانتبه لمستوى الجهد. افتراضيه في واجهة البرمجة high، بينما التطبيقات وClaude Code تعمل بـ medium، وهذا عكس Opus 5.5 الذي افتراضيه في الواجهة medium. والمستويات أعيدت معايرتها، فالوثائق تنصح بإعادة اختبارها بدل نقل الإعداد القديم، وبالبدء بـ medium للبرمجة الوكيلة المحددة جيدًا ثم high للمهام الأصعب والأطول.
متى يحوّل سونت 5.5 طلبك إلى Sonnet 5؟
هذا أول نموذج Sonnet يُطلق بضوابط للأمن السيبراني تشبه ضوابط Opus 5.5، لأن الشركة تقدّر أن قدراته في هذا المجال تقارب Opus 5. البحث عن الأخطاء في كودك وإصلاحها جزءًا من التطوير المعتاد مسموح، أما مهام الأمن السيبراني عالية الخطورة فتُحوَّل إلى Sonnet 5 تحويلًا ظاهرًا لا خفيًا. وتقول الشركة إن برنامج التحقق السيبراني سيتوسع قريبًا ليمنح المدافعين وصولًا متدرجًا إلى قدراته الأعلى.
في واجهة البرمجة يصل الرفض كاستجابة ناجحة (HTTP 200) قيمة stop_reason فيها refusal، ومعها فئة الرفض. والتحويل التلقائي من جهة الخادم (تجريبي) يعيد محاولة فئتي cyber وfrontier_llm على Sonnet 5، ولا يعيد فئات bio وreasoning_extraction وgeneral_harms، فجهّز تطبيقك للتعامل معها.
في البيولوجيا يطبّق النموذج ضوابط Sonnet 5 نفسها، مع إقرار الشركة بأن بعض طلبات الأحياء الدقيقة والفيروسات قد تُرفض خطأً، والمؤسسات تستطيع التقديم على برنامج التحقق لعلوم الحياة.
هل أختار سونت 5.5 أم Opus 5.5؟
هذا رأيي الشخصي، لا خبرًا. من يستعمل Claude في التطبيق للمهام اليومية، كتلخيص مستند أو كتابة بريد أو إصلاح دالة، لن يحتاج Opus 5.5 في أغلب الأوقات، وسيلاحظ فرق السرعة من أول رد. ومن يبني على واجهة البرمجة ويهمه السعر، فهذا أول نموذج أنصح بتجربته للبرمجة الوكيلة محددة النطاق وإعداد المستندات والجداول.
أما العمل الطويل المفتوح، كتصميم نظام من الصفر، فالشركة نفسها تقول إن Opus 5.5 أقوى فيه بوضوح. وهناك تقسيم ذكره أحد المختبرين يستحق التجربة: كيفن نغو من Creator يقول إنه يطمئن لترك Sonnet 5.5 ينفّذ لعبة بعد أن يضع Opus 5.5 معماريتها. وأداة المستشار في واجهة البرمجة تتيح اقترانًا قريبًا من هذا: Sonnet 5.5 منفّذًا يستشير Opus 5.5.
ولا ترفع الجهد إلى أقصاه تلقائيًا. هامش FrontierCode يقول إن أقصى جهد خفّض النتيجة في مهام محددة النطاق، لأن النموذج صار يستدعي مهارة توزّع العمل على وكلاء فرعيين كثيرين. وهذا درس لمن يبني مهارات Claude لفريقه: المهارة الثقيلة تخدم المهمة الكبيرة وقد تفسد الصغيرة.
وإن كنت تقارنه بـ GPT-6 Sol بالسعر نفسه، فجدول أنثروبيك يضعه أمامه في GDPval-AA وAA-Briefcase وChartography، وفي FrontierCode أمامه بمستوى xhigh وخلفه بأقصى جهد. لكنها أرقام شركة تقارن نفسها بمنافس، فجرّب الاثنين على عملك أنت، وتفاصيل Sol في مقالي عن جي بي تي 6 سول ولونا.
ماذا فعل Sonnet 5.5 في ثلاث مهام عربية جرّبتها بنفسي؟
جرّبتُ Sonnet 5.5 مع Opus 5.5 وHaiku 5.5 على ثلاث مهام عربية قصيرة بالطلب نفسه، دون أدوات، داخل Claude Code. صُحّحت الإجابات دون أن يعرف المصحّح مصدرها، وأُعيد كل عدّ وحساب بالكود.
في مكافأة نهاية الخدمة بقاعدة مكتوبة في الطلب، وصل Sonnet إلى ٥٢٬٧٥٠ درهمًا مثل الآخرين، وأكّد أن القاعدة لا تخصم شيئًا بسبب الاستقالة فبقي داخل الطلب. أضاف Haiku ملاحظة عن قانون العمل لم يطلبها أحد.
في ثلاث نسخ إعلان بالعامية المصرية بحد ١٢٠ حرفًا، جاءت نسخ Sonnet الأقصر (٧٥ و٩٢ و٩٤ حرفًا)، بلهجة مصرية واضحة وإن بدت عامة. أكثر الثلاثة مصرية كان Haiku.
في تصحيح CSS لصفحة RTL نفّذ Sonnet التغييرات السبعة بسبب من جملة واحدة لكل تغيير، ورفع ارتفاع السطر إلى ١٫٦.
لم أجد في هذه المهام ما يتفوق به Opus على Sonnet، وسعر Sonnet أقل. هذا لا يعني أن الأمر نفسه في المهام الطويلة المعقدة التي يقيسها جدول أنثروبيك.
قبل أن تبني قرارك على أرقام الإعلان
أرقام الجدول من إعلان أنثروبيك ووثائقها يوم الإطلاق، وأرقام العملاء كما نقلتها الشركة عنهم. وليس عندي اختبار شامل، فما جرّبته ثلاث مهام عربية قصيرة، ولم أقارن بين Sonnet 5.5 وHaiku 5.5 إلا فيها. ولن تجد هنا الخطط التي تحصل على Sonnet 5.5، ولا إن كان سيحل محل Sonnet 5 في الخطة المجانية، لأن الإعلان لم يذكر ذلك. وطريقة إجراء كل اختبار موجودة في بطاقة النظام (System Card) المنشورة مع النموذج، وشرحها ليس هنا.